day08【Collections、Set、Map、斗地主排序】 今日内容
Collections工具类
Set集合
Map集合
集合的嵌套
综合案例
教学目标
第一章 Collections类 知识点– Collections常用功能 目标
路径
讲解
public static void shuffle(List<?> list) :打乱集合顺序。
public static <T> void sort(List<T> list):将集合中元素按照默认规则排序。
public static <T> void sort(List<T> list,Comparator<? super T> ):将集合中元素按照指定规则排序。
shuffle方法代码演示:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
package com.itheima.demo1_Collections常用功能;import java.util.ArrayList;import java.util.Collections;import java.util.List;public class Test1_shuffle public static void main (String[] args) new ArrayList<>();300 );100 );200 );500 );400 );"打乱顺序之前的集合:" +list);"打乱顺序之后的集合:" +list);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
package com.itheima.demo1_Collections常用功能;public class Student implements Comparable <Student >int age;public Student (int age) this .age = age;@Override public String toString () return "Student{" +"age=" + age +'}' ;@Override public int compareTo (Student o) return this .age - o.age;package com.itheima.demo1_Collections常用功能;import java.util.ArrayList;import java.util.Collections;import java.util.List;public class Test2_sort public static void main (String[] args) new ArrayList<>();300 );100 );200 );500 );400 );"排序之前的集合:" +list); "排序之后的集合:" +list); "=========================================" );new ArrayList<>();new Student(19 );new Student(18 );new Student(20 );new Student(17 );"排序之前的集合:" +list1);"排序之后的集合:" +list1);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
package com.itheima.demo1_Collections常用功能;import java.util.ArrayList;import java.util.Collections;import java.util.Comparator;import java.util.List;public class Test3_sort public static void main (String[] args) new ArrayList<>();300 );100 );200 );500 );400 );"排序之前的集合:" + list); new Comparator<Integer>() {@Override public int compare (Integer o1, Integer o2) return o2 - o1;"排序之后的集合:" + list); new Comparator<Integer>() {@Override public int compare (Integer o1, Integer o2) return o1 - o2;"排序之后的集合:" + list);"=======================================" );new ArrayList<>();new Student(19 );new Student(18 );new Student(20 );new Student(17 );"排序之前的集合:" + list1);new Comparator<Student>() {@Override public int compare (Student o1, Student o2) return o2.age - o1.age;"排序之后的集合:" + list1);new Comparator<Student>() {@Override public int compare (Student o1, Student o2) return o1.age - o2.age;"排序之后的集合:" + list1);
小结 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 - public static void shuffle (List<?> list) :打乱集合顺序。- public static <T> void sort (List<T> list) :将集合中元素按照默认规则排序。 默认规则: 事先写好的排序规则 在哪里写好排序规则?---->集合元素所属的类中写好排序规则(通过实现Comparable接口,重写compareTo(T o) 方法写好排序规则) 排序规则: 前减后 升序 后减前 降序 前: this 后:参数 - public static <T> void sort (List<T> list,Comparator<? super T> com) :将集合中元素按照指定规则排序。 指定规则排序: 通过Comparator参数来指定 通过传入Comparator接口的匿名内部类,重写compare (T o1,T o2) 方法,在该方法中指定排序规则 排序规则: 前减后 升序 后减前 降序 前: 第一个参数 后:第二个参数
知识点– 可变参数 目标
路径
可变参数的使用
注意事项
应用场景: Collections
讲解 可变参数的使用 在JDK1.5 之后,如果我们定义一个方法需要接受多个参数,并且多个参数类型一致,我们可以对其简化.
格式:
1 修饰符 返回值类型 方法名(参数类型... 形参名){ }
代码演示:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 package com.itheima.demo2_可变参数;public class Test1 public static void main (String[] args) 10 ,20 ,30 ,40 ,50 );public static void method3 (int ... nums) for (int i = 0 ; i < nums.length; i++) {public static void method2 (int [] arr) for (int i = 0 ; i < arr.length; i++) {public static void method1 (int num1,int num2,int num3,int num4,int num5)
注意事项 1.一个方法只能有一个可变参数
2.如果方法中有多个参数,可变参数要放到最后。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 package com.itheima.demo2_可变参数;public class Test2 public static void main (String[] args) "itheima" ,10 ,20 );public static void method3 (String str,int ... nums)
应用场景: Collections 在Collections中也提供了添加一些元素方法:
public static <T> boolean addAll(Collection<T> c, T... elements) :往集合中添加一些元素。
代码演示:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 package com.itheima.demo2_可变参数;import java.util.ArrayList;import java.util.Collections;public class Test3 public static void main (String[] args) new ArrayList<>();"2" ,"A" ,"K" ,"Q" ,"J" ,"10" ,"9" ,"8" ,"7" ,"6" ,"5" ,"4" ,"3" );
小结 略
第二章 Set接口 知识点–Set接口介绍 目标
路径
讲解 1 2 3 4 5 6 7 8 Set接口:也称Set集合,但凡是实现了Set接口的类都叫做Set集合1. Set集合没有特殊的方法,都是使用Collection接口的方法2. Set集合没有索引,所以遍历元素的方式就只有: 增强for 循环,或者迭代器
小结 略
知识点–HashSet集合 目标
路径
讲解 java.util.HashSet是Set接口的一个实现类,它所存储的元素是不可重复的,并且元素都是无序的(即存取顺序不能保证不一致)。
我们先来使用一下Set集合存储,看下现象,再进行原理的讲解:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 public class Test public static void main (String[] args) new HashSet<>();"nba" );"cba" );"bac" );"abc" );"nba" );
小结 略
知识点–HashSet集合存储数据的结构(哈希表) 目标
路径
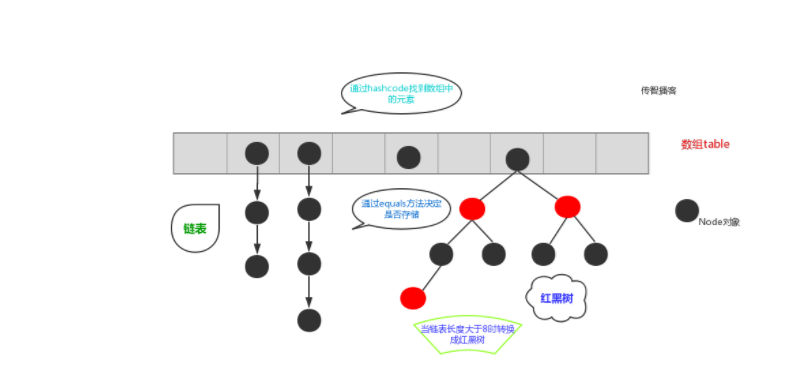
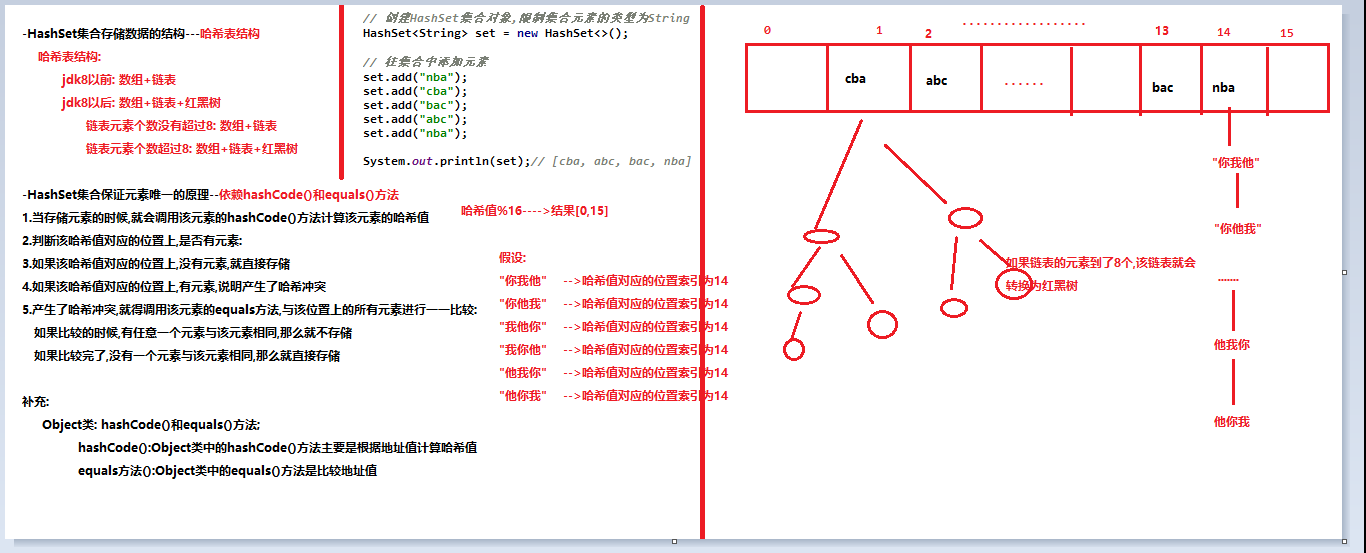
讲解 哈希表底层结构 在JDK1.8 之前,哈希表底层采用数组+链表实现,即使用数组处理冲突,同一hash值的链表都存储在一个数组里。但是当位于一个桶中的元素较多,即hash值相等的元素较多时,通过key值依次查找的效率较低。而JDK1.8中,哈希表存储采用数组+链表+红黑树实现,当链表长度超过阈值(8)时,将链表转换为红黑树,这样大大减少了查找时间。
简单的来说,哈希表是由数组+链表+红黑树(JDK1.8增加了红黑树部分)实现的,如下图所示。
HashSet保证元素唯一原理 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 -HashSet集合存储数据的结构---哈希表结构8 : 数组+链表8 : 数组+链表+红黑树1. 当存储元素的时候,就会调用该元素的hashCode()方法计算该元素的哈希值2. 判断该哈希值对应的位置上,是否有元素:3. 如果该哈希值对应的位置上,没有元素,就直接存储4. 如果该哈希值对应的位置上,有元素,说明产生了哈希冲突5. 产生了哈希冲突,就得调用该元素的equals方法,与该位置上的所有元素进行一一比较:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 public class Demo public static void main (String[] args) new HashSet<>();"nba" );"cba" );"bac" );"abc" );"nba" );for (String e : set) {"nba" .hashCode());"cba" .hashCode());"bac" .hashCode());"abc" .hashCode());
小结 略
扩展 HashSet的源码分析 3.4.1 HashSet的成员属性及构造方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 public class HashSet <E > extends AbstractSet <E > implements Set <E >, Cloneable , java .io .Serializable {private transient HashMap<E,Object> map;private static final Object PRESENT = new Object();public HashSet () new HashMap<>();
通过构造方法可以看出,HashSet构造时,实际上是构造一个HashMap
3.4.2 HashSet的add方法源码解析 1 2 3 4 5 6 7 public class HashSet public boolean add (E e) return map.put(e, PRESENT)==null ;
3.4.3 HashMap的put方法源码解析 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 public class HashMap public V put (K key, V value) return putVal(hash(key), key, value, false , true );static final int hash (Object key) int h;return (key == null ) ? 0 : (h = key.hashCode()) ^ (h >>> 16 );final V putVal (int hash, K key, V value, boolean onlyIfAbsent, boolean evict) int n, i;if ((tab = table) == null || (n = tab.length) == 0 )if ((p = tab[i = (n - 1 ) & hash]) == null )null );else {if (p.hash == hash &&null && key.equals(k))))else if (p instanceof TreeNode)this , tab, hash, key, value);else {for (int binCount = 0 ; ; ++binCount) {if ((e = p.next) == null ) {null );if (binCount >= TREEIFY_THRESHOLD - 1 ) break ;if (e.hash == hash &&null && key.equals(k))))break ;if (e != null ) { if (!onlyIfAbsent || oldValue == null )return oldValue;if (++size > threshold)return null ;
知识点– HashSet存储自定义类型元素 1.目标
2.路径
3.讲解 给HashSet中存放自定义类型元素时,需要重写对象中的hashCode和equals方法,建立自己的比较方式,才能保证HashSet集合中的对象唯一.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 public class Person public String name;public int age;public Person () public Person (String name, int age) this .name = name;this .age = age;@Override public String toString () return "Person{" +"name='" + name + '\'' +", age=" + age +'}' ;@Override public boolean equals (Object o) if (this == o) return true ;if (o == null || getClass() != o.getClass()) return false ;return age == person.age &&@Override public int hashCode () return Objects.hash(name, age);
创建测试类:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 public class Demo public static void main (String[] args) new Person("张三" , 18 );new Person("李四" , 38 );new Person("王五" , 28 );new Person("张三" , 18 );new HashSet<>();for (Person p : set) {
小结 略
知识点– LinkedHashSet 目标
使用LinkedHashSet保证元素怎么存就怎么取,即存取有序
路径
讲解 我们知道HashSet保证元素唯一,可是元素存放进去是没有顺序的,那么我们要保证有序,怎么办呢?
在HashSet下面有一个子类java.util.LinkedHashSet,它是链表和哈希表组合的一个数据存储结构。
演示代码如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 package com.itheima.demo5_LinkedHashSet;import java.util.HashSet;import java.util.LinkedHashSet;public class Test public static void main (String[] args) new LinkedHashSet<>();300 );100 );200 );500 );400 );400 );
小结 略
知识点– TreeSet集合 目标
知道使用TreeSet集合的特点并能够使用TreeSet集合
路径
讲解 特点 TreeSet集合是Set接口的一个实现类,底层依赖于TreeMap,是一种基于红黑树 的实现,其特点为:
元素唯一
元素没有索引
使用元素的自然顺序 对元素进行排序,或者根据创建 TreeSet 时提供的 Comparator
1 2 public TreeSet () : 根据其元素的自然排序进行排序public TreeSet (Comparator<E> comparator) : 根据指定的比较器进行排序
演示 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 package com.itheima.demo6_TreeSet集合;import java.util.Comparator;import java.util.LinkedHashSet;import java.util.TreeSet;public class Test public static void main (String[] args) new TreeSet<>();300 );100 );200 );500 );400 );400 );"===========================================" );new TreeSet<>(new Comparator<Integer>() {@Override public int compare (Integer o1, Integer o2) return o2 - o1;300 );100 );200 );500 );400 );400 );"===========================================" );new TreeSet<>(new Comparator<Integer>() {@Override public int compare (Integer o1, Integer o2) return o1 - o2;300 );100 );200 );500 );400 );400 );
小结 略
第三章 Map集合 知识点– Map概述 目标
路径
讲解
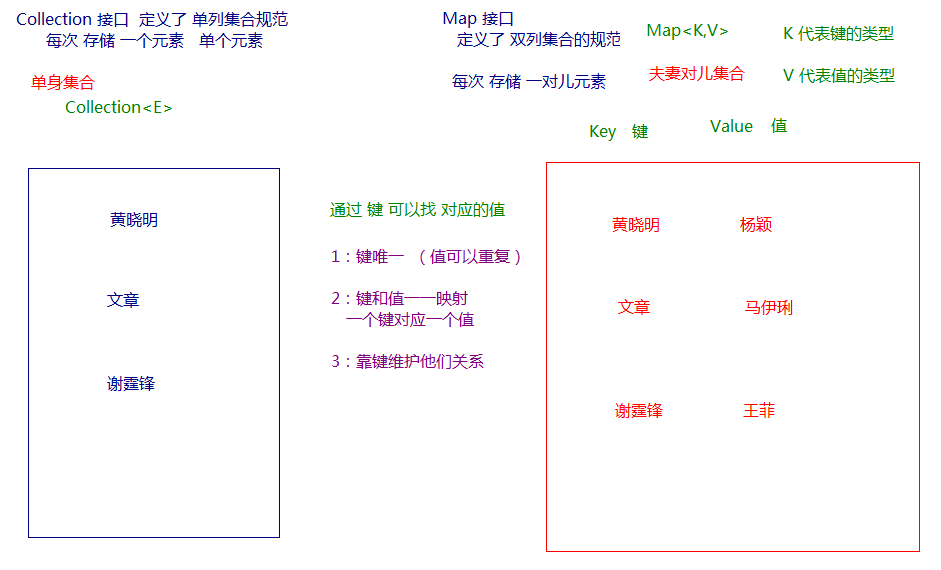
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 Map<K,V>集合的特点: K用来限制键的类型,V用来限制值的类型1. Map集合存储元素是以键值对的形式存储,每一个键值对都有键和值2. Map集合的键是唯一,值可以重复,如果键重复了,那么值就会被覆盖3. 根据键取值
小结 略
知识点– Map的常用方法 目标
路径
讲解 Map接口中定义了很多方法,常用的如下:
public V put(K key, V value): 把指定的键与指定的值添加到Map集合中。public V remove(Object key): 把指定的键 所对应的键值对元素 在Map集合中删除,返回被删除元素的值。public V get(Object key) 根据指定的键,在Map集合中获取对应的值。public boolean containsKey(Object key):判断该集合中是否有此键public Set<K> keySet(): 获取Map集合中所有的键,存储到Set集合中。public Set<Map.Entry<K,V>> entrySet(): 获取到Map集合中所有的键值对对象的集合(Set集合)。
Map接口的方法演示
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 package com.itheima.demo7_Map的常用方法;import java.util.Collection;import java.util.HashMap;import java.util.Map;import java.util.Set;public class Test public static void main (String[] args) new HashMap<>();"黄晓明" , "杨颖" );"文章" , "马伊琍" );"谢霆锋" , "王菲" );"文章" , "姚笛" );"v1:" +v1);"李亚鹏" , "王菲" );"v2:" +v2);"文章" );"被删除键值对的值:" +v3);"黄晓明" );"value:" +value);"黄晓明" ));"文章" ));"杨颖" ));"马伊琍" ));"keys:" +keys);"values:" +values);
tips:
使用put方法时,若指定的键(key)在集合中没有,则没有这个键对应的值,返回null,并把指定的键值添加到集合中;
若指定的键(key)在集合中存在,则返回值为集合中键对应的值(该值为替换前的值),并把指定键所对应的值,替换成指定的新值。
小结 略
知识点–Map的遍历 目标
路径
讲解 方式1:键找值方式 通过元素中的键,获取键所对应的值
分析步骤:
获取Map中所有的键,由于键是唯一的,所以返回一个Set集合存储所有的键。方法提示:keyset()
遍历键的Set集合,得到每一个键。
根据键,获取键所对应的值。方法提示:get(K key)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 public class Demo public static void main (String[] args) new HashMap<>();"黄晓明" , "杨颖" );"文章" , "马伊琍" );"谢霆锋" , "王菲" );for (String key : keys) {"键:" +key+",值:" +value);
方式2:键值对方式 1 2 3 4 5 6 7 8 9 10 11 12 13 14 Entry < K , V > 接口: 简称Entry 项, 表示键值对对象, 用来封装Map 集合中的键值对Entry < K , V > 接口: 是Map 接口中的内部接口, 在外部使用的时候是这样表示: Map . Entry < K , V > Map 集合中提供了一个方法来获取所有键值对对象: public Set < Map . Entry < K , V >> entrySet ( ) : - public K getKey ( ) :获取Entry 对象中的键。- public V getValue ( ) :获取Entry 对象中的值。Map 遍历方式二: 根据键值对对象的方式1. 获取集合中所有键值对对象,以Set 集合形式返回。 Set < Map . Entry < K , V >> entrySet ( ) 2. 遍历所有键值对对象的集合,得到每一个键值对( Entry ) 对象。3. 在循环中, 可以使用键值对对对象获取键和值 getKey ( ) 和getValue ( )
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 public class Demo public static void main (String[] args) new HashMap<>();"黄晓明" , "杨颖" );"文章" , "马伊琍" );"谢霆锋" , "王菲" );for (Map.Entry<String, String> entry : entrySet) {"键:" +key+",值:" +value);
小结 略
知识点– HashMap存储自定义类型 目标
路径
讲解 练习:每位学生(姓名,年龄)都有自己的家庭住址。那么,既然有对应关系,则将学生对象和家庭住址存储到map集合中。学生作为键, 家庭住址作为值。
注意,学生姓名相同并且年龄相同视为同一名学生。
编写学生类:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 public class Student public String name;public int age;public Student () public Student (String name, int age) this .name = name;this .age = age;@Override public String toString () return "Student{" +"name='" + name + '\'' +", age=" + age +'}' ;@Override public boolean equals (Object o) if (this == o) return true ;if (o == null || getClass() != o.getClass()) return false ;return age == student.age &&@Override public int hashCode () return Objects.hash(name, age);
编写测试类:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 public class Demo public static void main (String[] args) new HashMap<>();new Student("张三" , 18 );new Student("李四" , 38 );new Student("王五" , 28 );new Student("张三" , 18 );"北京" );"上海" );"深圳" );"广州" );
当给HashMap中存放自定义对象时,如果自定义对象作为key存在,这时要保证对象唯一,必须复写对象的hashCode和equals方法(如果忘记,请回顾HashSet存放自定义对象)。
如果要保证map中存放的key和取出的顺序一致,可以使用java.util.LinkedHashMap集合来存放。
小结 略
知识点–LinkedHashMap介绍 目标
我们知道HashMap保证成对元素唯一,并且查询速度很快,可是成对元素存放进去是没有顺序的,那么我们要保证有序,还要速度快怎么办呢?
路径
讲解
通过链表结构可以保证元素的存取顺序一致;
通过哈希表结构可以保证的键的唯一、不重复,需要重写键的hashCode()方法、equals()方法。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 package com.itheima.demo10_LinkedHashMap;import java.util.LinkedHashMap;public class Test public static void main (String[] args) new LinkedHashMap<>();300 , "深圳" );100 , "北京" );200 , "广州" );500 , "上海" );400 , "武汉" );400 , "深圳" );
小结 略
知识点–TreeMap集合 目标
路径
讲解 TreeMap介绍 TreeMap集合和Map相比没有特有的功能,底层的数据结构是红黑树;可以对元素的**键** 进行排序,排序方式有两种:自然排序 和比较器排序 ;到时使用的是哪种排序,取决于我们在创建对象的时候所使用的构造方法;
构造方法 1 2 public TreeMap () 使用自然排序public TreeMap (Comparator<? super K> comparator) 通过比较器指定规则排序
案例演示 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 package com.itheima.demo11_TreeMap集合;import java.util.Comparator;import java.util.LinkedHashMap;import java.util.TreeMap;public class Test public static void main (String[] args) new TreeMap<>();300 , "深圳" );100 , "北京" );200 , "广州" );500 , "上海" );400 , "武汉" );400 , "深圳" );"+=================================" );new TreeMap<>(new Comparator<Integer>() {@Override public int compare (Integer o1, Integer o2) return o2 - o1;300 , "深圳" );100 , "北京" );200 , "广州" );500 , "上海" );400 , "武汉" );400 , "深圳" );
小结 略
案例– Map集合练习 需求
分析
获取一个字符串对象
创建一个Map集合,键代表字符,值代表次数。
遍历字符串得到每个字符。
判断Map中是否有该键。
如果没有,第一次出现,存储次数为1;如果有,则说明已经出现过,获取到对应的值进行++,再次存储。
打印最终结果
实现 方法介绍
public boolean containKey(Object key):判断该集合中是否有此键。
代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 package com.itheima.demo12_Map集合练习;import java.util.HashMap;import java.util.Scanner;public class Test public static void main (String[] args) new Scanner(System.in);"请输入一个字符串:" );new HashMap<>();for (int i = 0 ; i < s.length(); i++) {char c = s.charAt(i);if (map.containsKey(c)) {else {1 );
小结 略
第四章 集合的嵌套
知识点–集合的嵌套 目标
路径
List嵌套List
List嵌套Map
Map嵌套Map
讲解 List嵌套List 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 public class Test1 public static void main (String[] args) new ArrayList<>();"王宝强" );"贾乃亮" );"陈羽凡" );new ArrayList<>();"马蓉" );"李小璐" );"白百何" );new ArrayList<>();for (List<String> e : list) {for (String name : e) {"=============" );
List嵌套Map 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 public class Test2 public static void main (String[] args) new HashMap<>();"it001" ,"迪丽热巴" );"it002" ,"古力娜扎" );new HashMap<>();"heima001" ,"蔡徐坤" );"heima002" ,"李易峰" );new ArrayList<>();for (Map<String, String> map : list) {for (String key : keys) {"," + map.get(key));
Map嵌套Map 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 public class Test3 public static void main (String[] args) new HashMap<>();"it001" ,"迪丽热巴" );"it002" ,"古力娜扎" );new HashMap<>();"heima001" ,"蔡徐坤" );"heima002" ,"李易峰" );new HashMap<>();"传智博客" ,map1);"黑马程序员" ,map2);for (String key : keys) {for (String k : keySet) {"," +v);
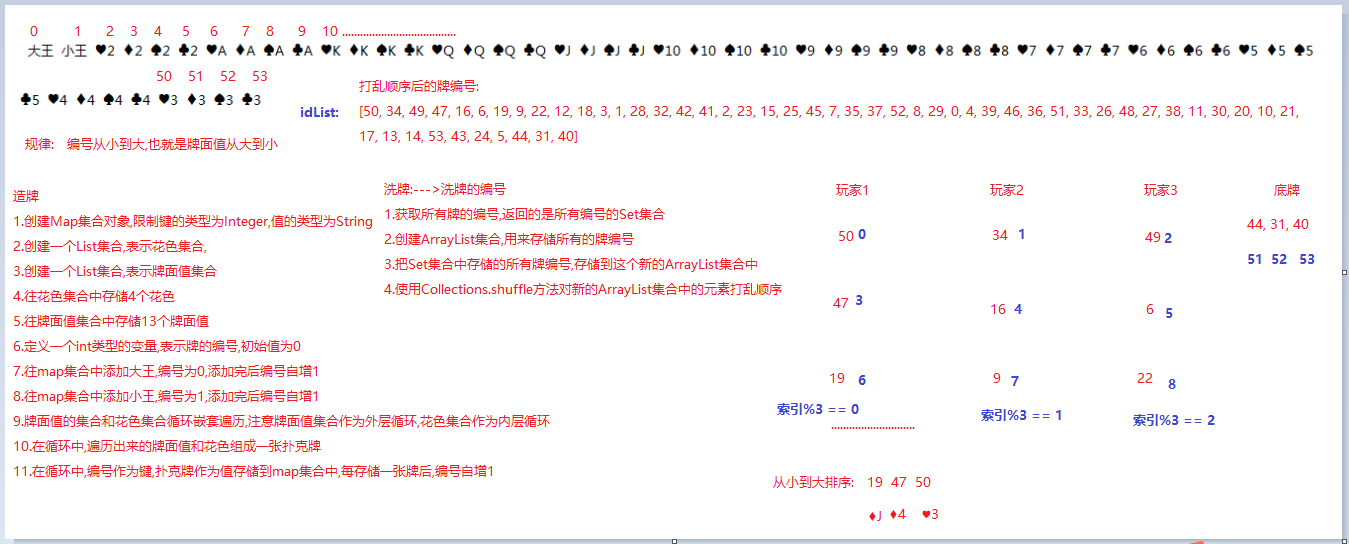
小结 第五章 模拟斗地主洗牌发牌 需求 按照斗地主的规则,完成洗牌发牌的动作。
具体规则:
组装54张扑克牌
54张牌顺序打乱
三个玩家参与游戏,三人交替摸牌,每人17张牌 ,最后三张留作底牌。
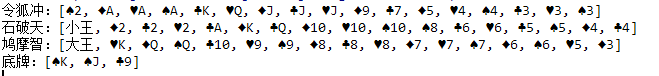
查看三人各自手中的牌(按照牌的大小排序)、底牌
规则:手中扑克牌从大到小的摆放顺序:大王,小王,2,A,K,Q,J,10,9,8,7,6,5,4,3
分析 1.准备牌:
完成数字与纸牌的映射关系:
使用双列Map(HashMap)集合,完成一个数字与字符串纸牌的对应关系(相当于一个字典)。
2.洗牌:
通过数字完成洗牌发牌
3.发牌:
将每个人以及底牌设计为ArrayList,将最后3张牌直接存放于底牌,剩余牌通过对3取模依次发牌。
存放的过程中要求数字大小与斗地主规则的大小对应。
将代表不同纸牌的数字分配给不同的玩家与底牌。
4.看牌:
通过Map集合找到对应字符展示。
通过查询纸牌与数字的对应关系,由数字转成纸牌字符串再进行展示。
实现 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 package com.itheima04;import java.util.ArrayList;import java.util.Collections;import java.util.HashMap;public class Test public static void main (String[] args) new HashMap<>();new ArrayList<>();new ArrayList<>();"♥" , "♦" , "♠" , "♣" );"2" , "A" , "K" , "Q" , "J" , "10" , "9" , "8" , "7" , "6" , "5" , "4" , "3" );int id = 0 ;"大王" );"小王" );for (String number : numbers) {for (String color : colors) {new ArrayList<>();"打乱顺序后的牌编号:" +idList.size());"打乱顺序后的牌编号:" +idList);new ArrayList<>();new ArrayList<>();new ArrayList<>();new ArrayList<>();for (int i = 0 ; i < idList.size(); i++) {if (i >= 51 ){else if (i%3 ==0 ){else if (i%3 ==1 ){else if (i%3 ==2 ){"玩家一的牌:" );for (Integer paiId : play1Id) {" " );"玩家二的牌:" );for (Integer paiId : play2Id) {" " );"玩家三的牌:" );for (Integer paiId : play3Id) {" " );"底牌的牌:" );for (Integer paiId : diPaiId) {" " );
小结 略
总结 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 必须练习:1. Collections工具类的常用方法2. Map集合的常用方法3. 自己总结Set集合的继承体系以及各个子集合的特点---->Set接口的介绍4. HashSet或者HashMap保证元素或者键唯一的原理5. 自己总结Map集合的继承体系以及各个子集合的特点---->Map接口的介绍6. 使用Map集合或者Set集合的子类---添加元素,遍历public static void shuffle (List<?> list) :打乱集合顺序。 - public static <T> void sort (List<T> list) :将集合中元素按照默认规则排序。集合元素所属的类必须实现Comparable接口,重写compareTo方法,在该方法中指定排序规则 - public static <T> void sort (List<T> list,Comparator<? super T> ) :将集合中元素按照指定规则排序。 - 能够使用Comparator比较器进行排序 重写compare (T o1,T o2) 方法,指定排序规则 排序规则: 前减后: 升序 后减前: 降序 - 能够使用可变参数 使用格式: 修饰符 返回值类型 方法名(数据类型... 变量名) {}1. 一个方法只能有一个可变参数2. 如果方法有多个参数,可变参数一定要放在最后1. Set集合没有特殊的方法,都是使用Collection接口的方法2. Set集合没有索引,所以遍历元素的方式就只有: 增强for 循环,或者迭代器1. 以键值对的形式存储数据2. 键唯一,值可重复,如果键重复了,值就会覆盖3. 根据键找值public V put (K key, V value) : 把指定的键与指定的值添加到Map集合中。 - public V remove (Object key) : 把指定的键 所对应的键值对元素 在Map集合中删除,返回被删除元素的值。 - public V get (Object key) 根据指定的键,在Map集合中获取对应的值。 - public boolean containsKey (Object key) :判断该集合中是否有此键 - public boolean containsValue (Object value) :判断该集合中是否有此值 - public Set<K> keySet () : 获取Map集合中所有的键,存储到Set集合中。 - public Collection<V> values () : 获取Map集合中所有的值,存储到Collection集合中。 - public Set<Map.Entry<K,V>> entrySet () : 获取到Map集合中所有的键值对对象的集 - 使用”键找值”的方式遍历Map集合 1.获取所有的键 2.遍历所有的键 3.根据键找值 - 使用”键值对”的方式遍历Map集合 1.获取所有的键值对对象 2.遍历所有的键值对对象 3.根据键值对对象找键或者找值 - 能够使用HashMap存储自定义键值对的数据 键所属的类需要重写hashCode和equals方法 - 能够完成斗地主洗牌发牌案例 略