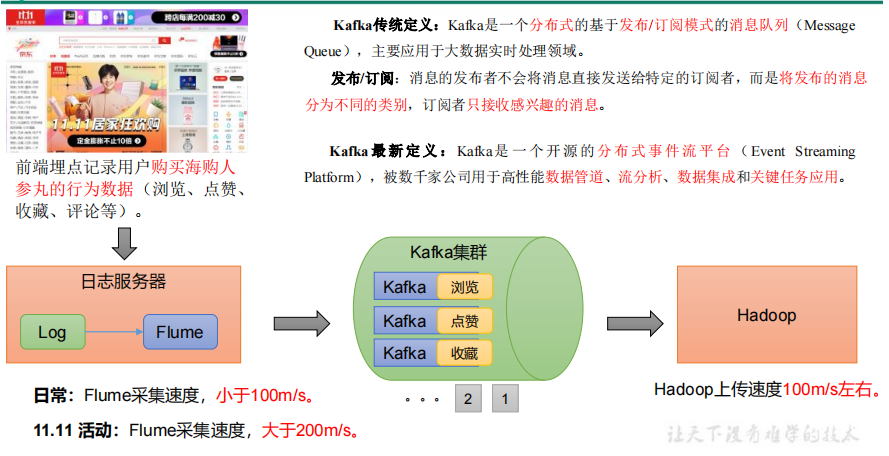
Kafka 第 1 章 Kafka 概述 1.1 定义
1.2 消息队列 目 前企 业中比 较常 见的 消息 队列产 品主 要有 Kafka、ActiveMQ 、RabbitMQ 、RocketMQ 等。
在大数据场景主要采用 Kafka 作为消息队列。在 JavaEE 开发中主要采用 ActiveMQ、RabbitMQ、RocketMQ。
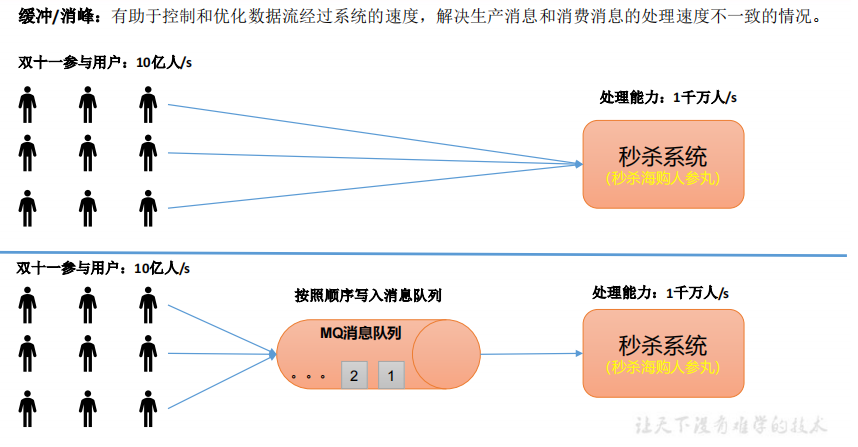
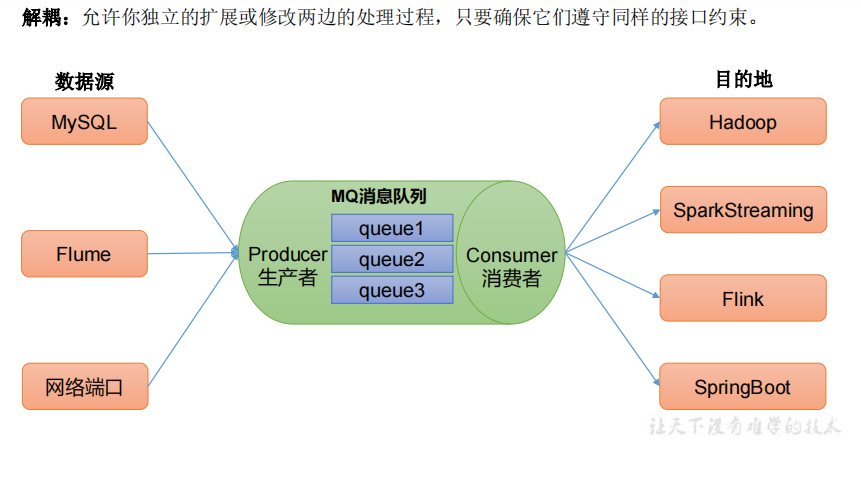
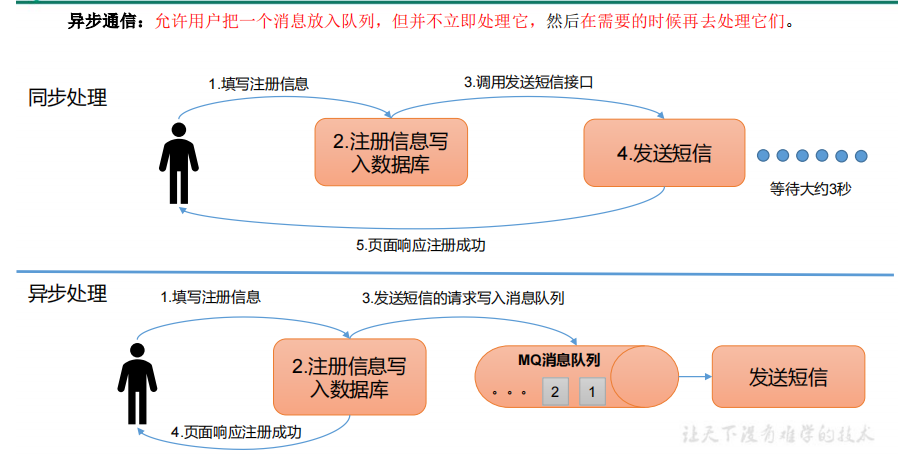
1.2.1 传统消息队列的应用场景 传统的消息队列的主要应用场景包括:缓存/消峰 、解耦 和异步通信。
消息队列的应用场景 ——缓冲/消峰
消息队列的应用场景——解耦
消息队列的应用场景 ——异步通信
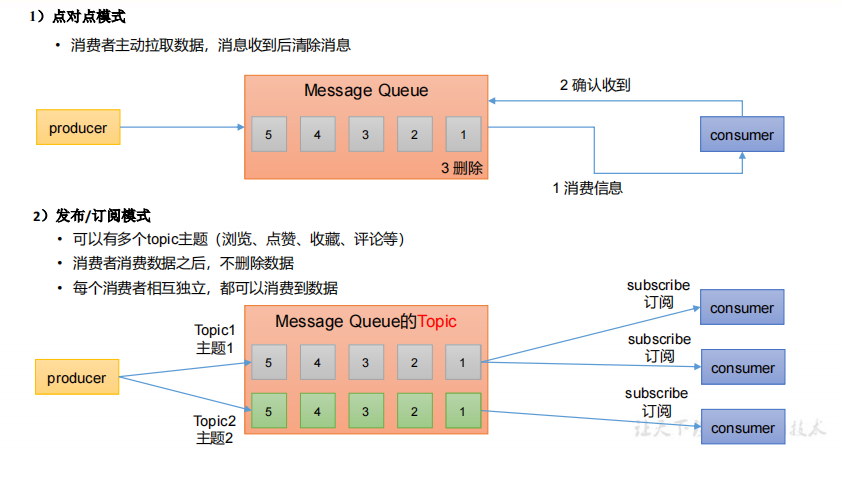
1.2.2 消息队列的两种模式
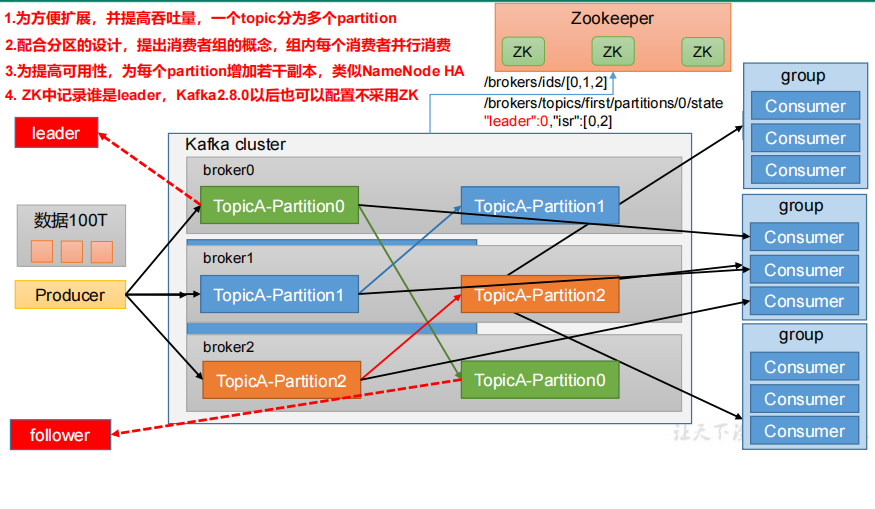
1.3 Kafka 基础架构
(1)Producer :消息生产者,就是向 Kafka broker 发消息的客户端。
(2)Consumer: 消息消费者,向 Kafka broker 取消息的客户端。
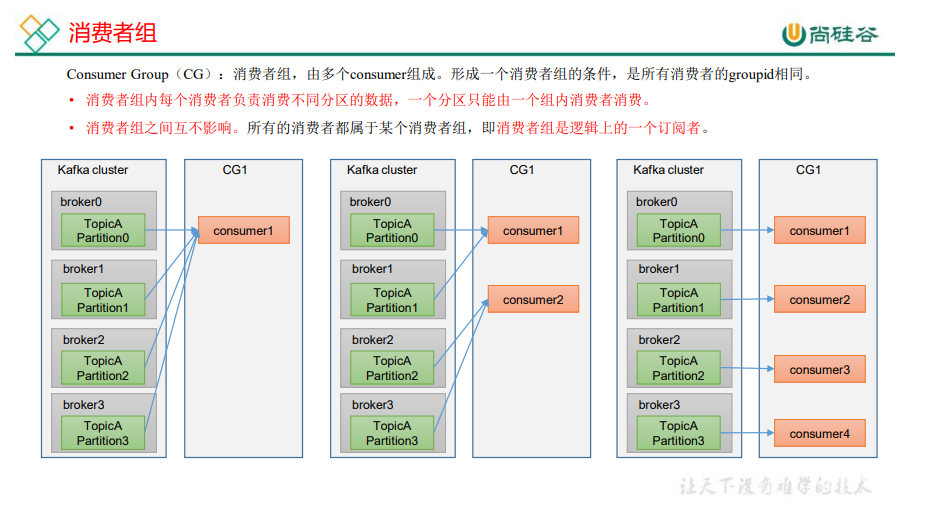
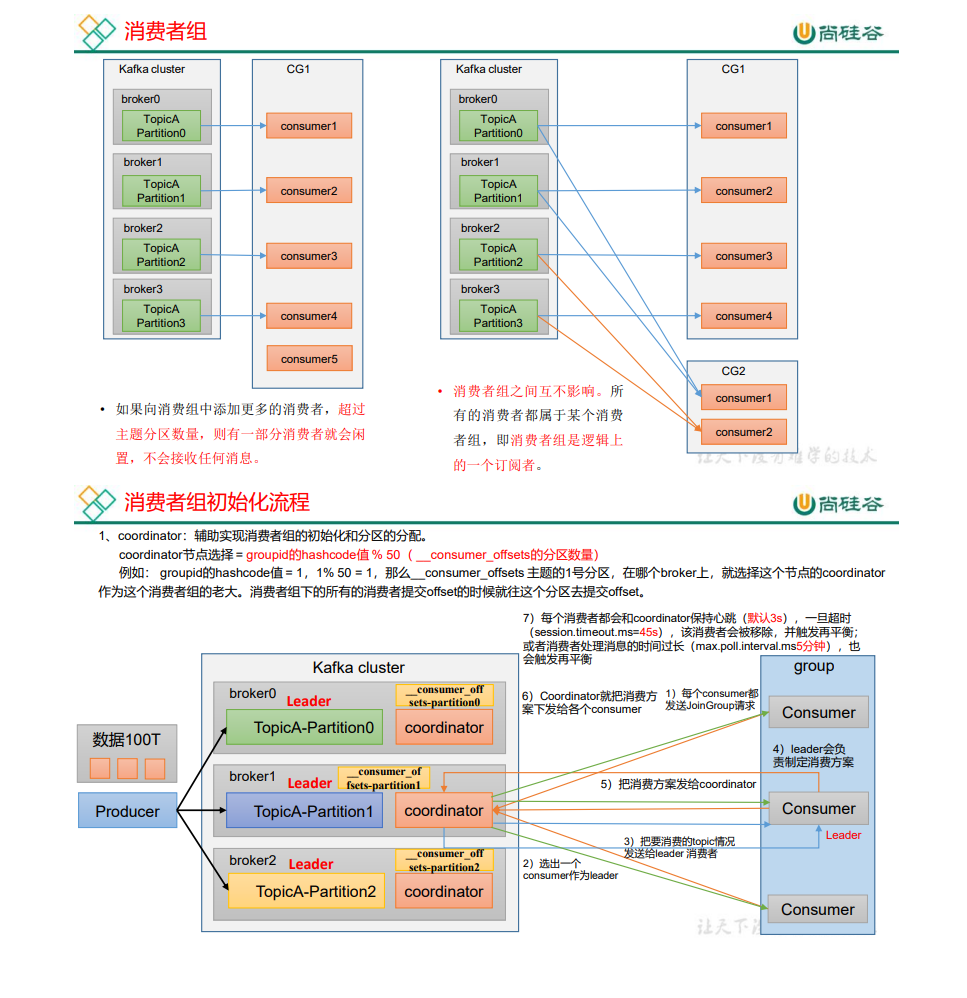
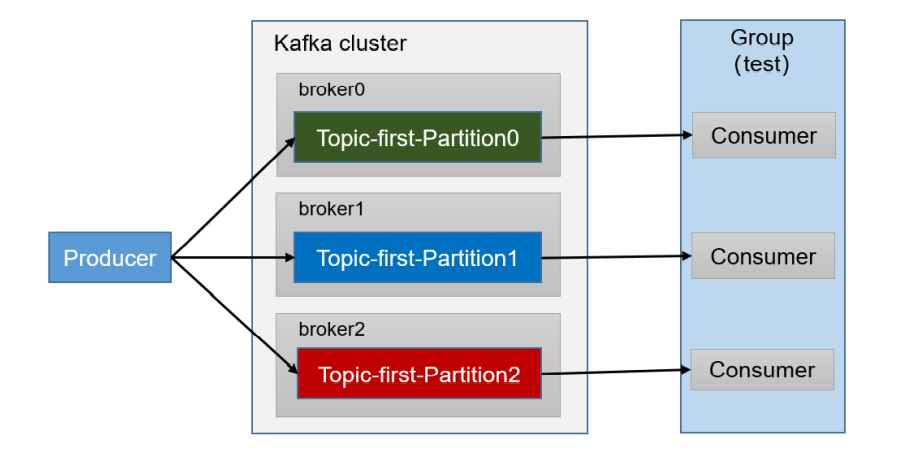
(3) Consumer Group(CG):消费者组,由多个 consumer 组成。 消费者组内每个消者负责消费不同分区的数据,一个分区只能由一个组内消费者消费;消费者组之间互不** 影响。所有的消费者都属于某个消费者组,即 消费者组是逻辑上的一个订阅者。
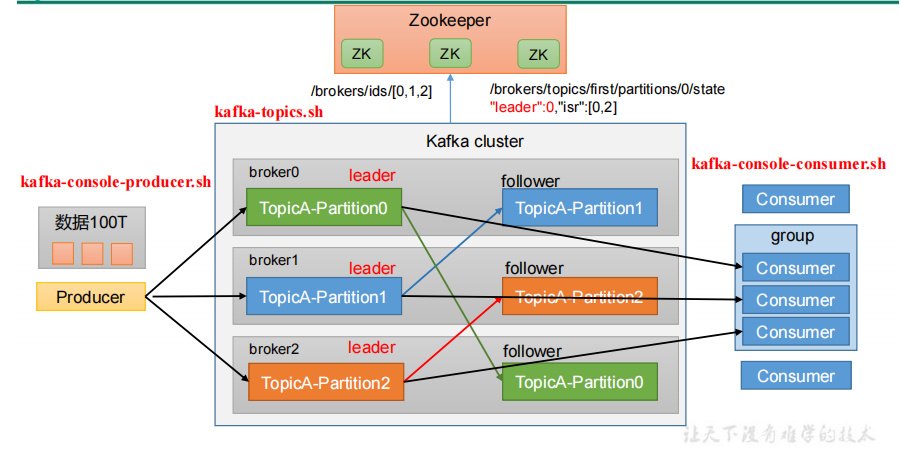
(4)Broker: 一台 Kafka 服务器就是一个 broker。一个集群由多个 broker 组成。一个broker 可以容纳多个 topic。
(5)Topic :可以理解为一个队列, 生产者和消费者面向的都是一个topic 。
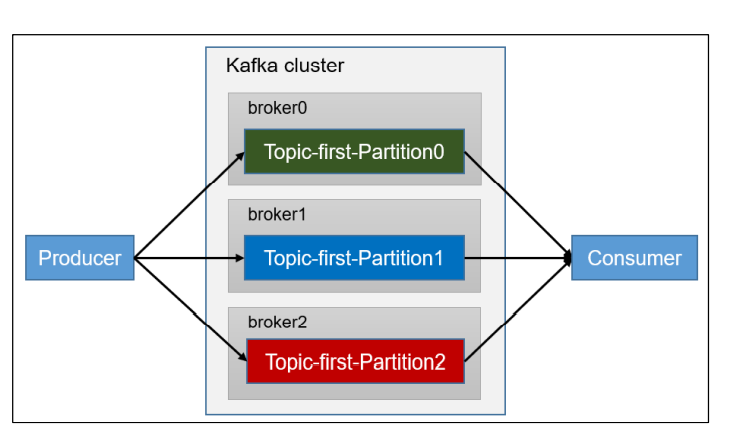
(6)Partition :为了实现扩展性,一个非常大的 topic 可以分布到多个 broker(即服务器)上,一个 topic 可以分为多个partition ,每个 partition 是一个有序的队列。
(7)Replica:副本 。一个 topic 的每个分区都有若干个副本,一个 Leader 和若干个
Follower 。
(8)Leader: 每个分区多个副本的“主”,生产者发送数据的对象,以及消费者消费数
据的对象都是 Leader。
(9)Follower :每个分区多个副本中的“从”,实时从 Leader 中同步数据,保持和Leader 数据的同步。Leader 发生故障时,某个 Follower 会成为新的 Leader。
第 2 章 Kafka 快速入门 2.1 安装部署 2.1.1 集群规划
hadoop102
hadoop103
hadoop104
zk
zk
zk
kafka
kafka
kafka
2.1.2 集群部署 0 )官方下载地址:http://kafka.apache.org/downloads.html
1 )解压安装包
1 [atguigu@hadoop102 software]$ tar -zxvf kafka_2.12-3.0.0.tgz -C /opt/module/
2 )修改解压后的文件名称
1 [atguigu@hadoop102 module]$ mv kafka_2.12-3.0.0/ kafka
3 )进入到/opt/module/kafka 目录,修改配置文件
1
2
[atguigu@hadoop102 kafka]$ cd config/
输入以下内容:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 broker.id =0 num.network.threads =3 num.io.threads =8 socket.send.buffer.bytes =102400 socket.receive.buffer.bytes =102400 socket.request.max.bytes =104857600 配置多个磁盘路径,路径与路径之间可以用","分隔 log.dirs =/opt/module/kafka/datas num.partitions =1 num.recovery.threads.per.data.dir =1 offsets.topic.replication.factor =1 log.retention.hours =168 log.segment.bytes =1073741824 log.retention.check.interval.ms =300000 zookeeper.connect =hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka
4 )分发安装包
1 [atguigu@hadoop102 module]$ xsync kafka/
5 )分别在 hadoop103 和 hadoop104 上修改配置文件/opt/module/kafka/config/server.properties中的 broker.id=1、broker.id=2
注:broker.id 不得重复,整个集群中唯一。
1
2
3
4
5
6
7
8
[atguigu@hadoop103 module]$ vim kafka/config/server.properties# The id of the broker. This must be set to a unique integer for # The id of the broker. This must be set to a unique integer for
6 )配置环境变量
(1)在/etc/profile.d/my_env.sh 文件中增加 kafka 环境变量配置
1 [atguigu@hadoop102 module]$ sudo vim /etc/profile.d/my_env.sh
增加如下内容:
1
2
3
# KAFKA_HOME
(2)刷新一下环境变量。
1 [atguigu@hadoop102 module]$ source /etc/profile
(3)分发环境变量文件到其他节点,并 source。
1
2
3
[atguigu@hadoop102 module]$ sudo /home/atguigu/bin/xsync /etc/profile.d/my_env.sh
7 )启动集群
(1)先启动 Zookeeper 集群,然后启动 Kafka。
1 [atguigu@hadoop102 kafka]$ zk.sh start
(2)依次在 hadoop102、hadoop103、hadoop104 节点上启动 Kafka。
1
2
3
4
5
6
[atguigu@hadoop102 kafka]$ bin/kafka-server-start.sh -daemon
注意:配置文件的路径要能够到 server.properties。
8 )关闭集群
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-server-stop.sh
2.1.3 集群启停脚本 1)在/home/atguigu/bin 目录下创建文件 kf.sh 脚本文件
1 [atguigu@hadoop102 bin]$ vim kf.sh
脚本如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# ! /bin/bash
2)添加执行权限
1 [atguigu@hadoop102 bin]$ chmod +x kf.sh
3)启动集群命令
1 [atguigu@hadoop102 ~]$ kf.sh start
4)停止集群命令
1 [atguigu@hadoop102 ~]$ kf.sh stop
注意: 停止 Kafka 集群时,一定要等 Kafka 所有节点进程全部停止后再停止 Zookeeper集群。因为 Zookeeper 集群当中记录着 Kafka 集群相关信息,Zookeeper 集群一旦先停止,Kafka 集群就没有办法再获取停止进程的信息,只能手动杀死 Kafka 进程了。
2.2 Kafka 命令行操作
2.2.1 主题命令行操作 1)查看操作主题命令参数
1 [atguigu@hadoop102 kafka]$ bin/kafka-topics.sh
参数
描述
–bootstrap-server <String: server toconnect to>
连接的 Kafka Broker 主机名称和端口号。
–topic <String: topic>
操作的 topic 名称。
–create
创建主题。
–delete
删除主题。
–alter
修改主题。
–list
查看所有主题。
–describe
查看主题详细描述。
–partitions <Integer: # of partitions>
设置分区数。
–replication-factor<Integer: replication factor>
设置分区副本。
–config <String: name=value>
更新系统默认的配置。
2)查看当前服务器中的所有 topic
1 [atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --list
3)创建 first topic
1 [atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --create --partitions 1 --replication-factor 3 --topic first
选项说明:
–topic 定义 topic 名
–replication-factor 定义副本数
–partitions 定义分区数
4)查看 first 主题的详情
1 [atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --describe --topic first
5)修改分区数(注意:分区数只能增加,不能减少 )
1 [atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --alter --topic first --partitions 3
6)再次查看 first 主题的详情
1 [atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --describe --topic first
7)删除 topic
1
2
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
2.2.2 生产者命令行操作 1)查看操作生产者命令参数
1 [atguigu@hadoop102 kafka]$ bin/kafka-console-producer.sh
参数
描述
–bootstrap-server <String: server toconnect to>
连接的 Kafka Broker 主机名称和端口号。
–topic <String: topic>
操作的 topic 名称。
2)发送消息
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-console-producer.sh --bootstrap-server hadoop102:9092 --topic first> hello world > atguigu atguigu
2.2.3 消费者命令行操作 1)查看操作消费者命令参数
1 [atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh
参数
描述
–bootstrap-server <String: server toconnect to>
连接的 Kafka Broker 主机名称和端口号。
–topic <String: topic>
操作的 topic 名称。
–from-beginning
从头开始消费。
–group <String: consumer group id>
指定消费者组名称。
2)消费消息
(1)消费 first 主题中的数据。
1 [atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
(2)把主题中所有的数据都读取出来(包括历史数据)。
1 [atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --from-beginning --topic first
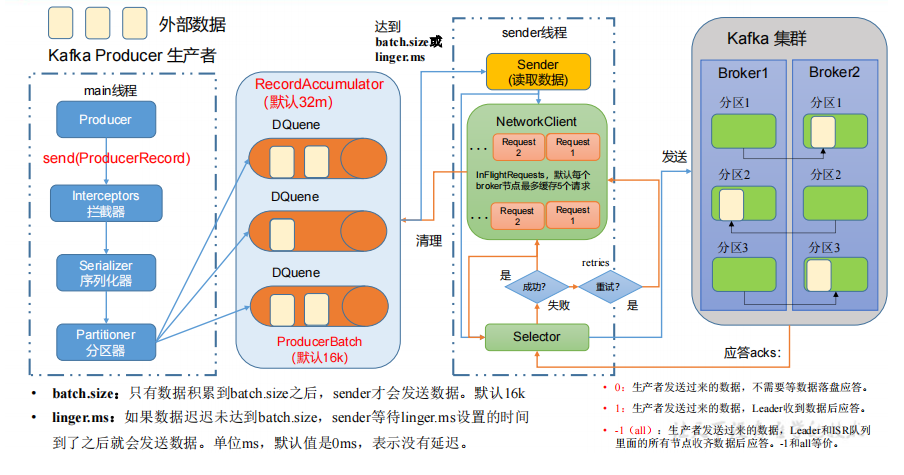
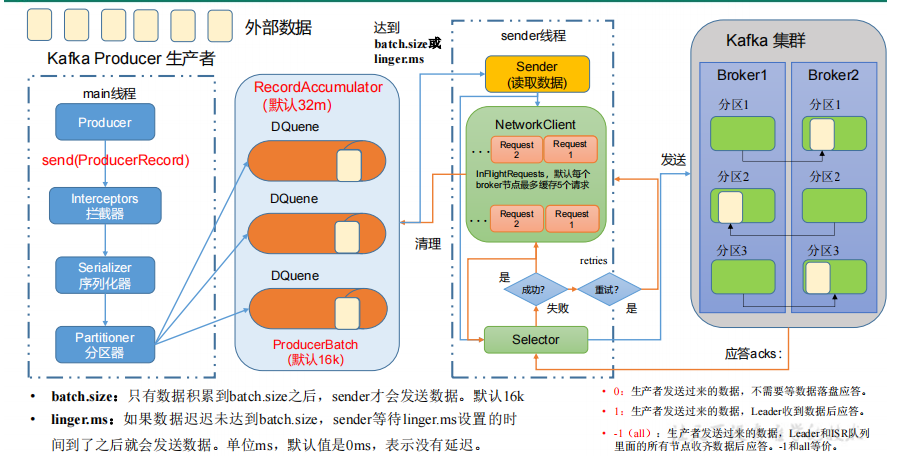
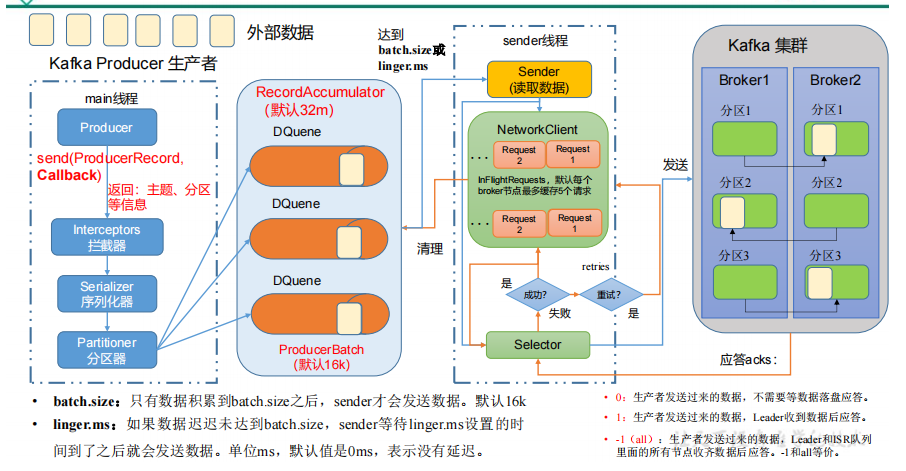
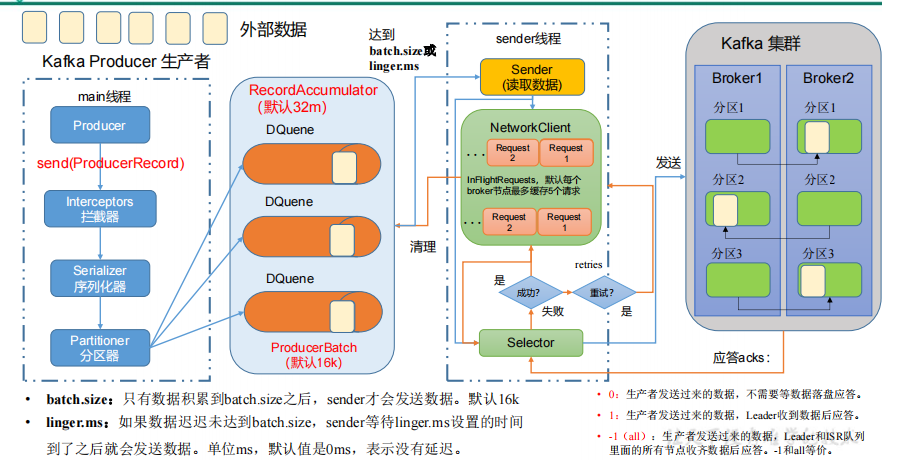
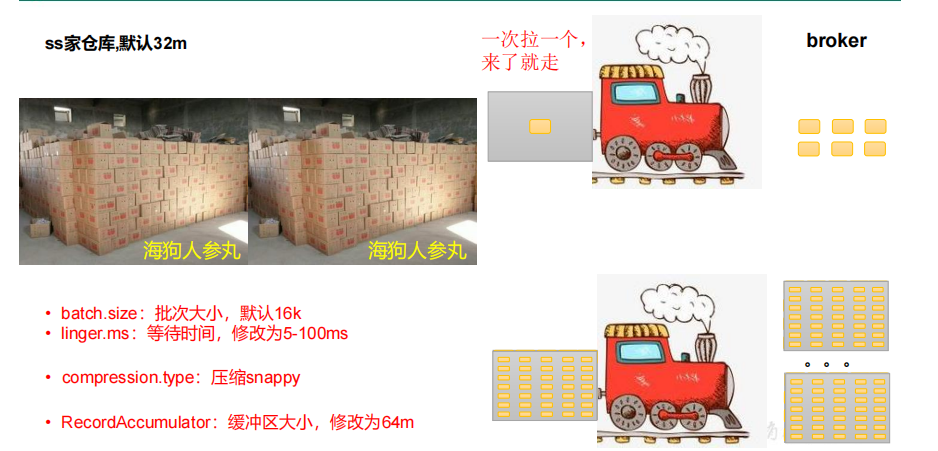
第 3 章 Kafka 生产者 3.1 生产者消息发送流程 3.1.1 发送原理 在消息发送的过程中,涉及到了两个线程——main 线程和 Sender 线程 。在 main 线程中创建了一个双端队列 RecordAccumulator 。main 线程将消息发送给 RecordAccumulator,Sender 线程不断从 RecordAccumulator 中拉取消息发送到 Kafka Broker。
关于RecordAccumulator的详细介绍看:https://blog.csdn.net/liyiming2017/article/details/88976535
3.1.2 生产者重要参数列表
参数名称
描述
bootstrap.servers
生产者连接集群所需的 broker 地 址 清 单 。 例 如hadoop102:9092,hadoop103:9092,hadoop104:9092,可以设置 1 个或者多个,中间用逗号隔开。注意这里并非需要所有的 broker 地址,因为生产者从给定的 broker里查找到其他 broker 信息。
key.serializer 和 value.serializer
指定发送消息的 key 和 value 的序列化类型。一定要写全类名。
buffer.memory
RecordAccumulator 缓冲区总大小,默认 32m 。
batch.size
缓冲区一批数据最大值,默认 16k 。适当增加该值,可以提高吞吐量,但是如果该值设置太大,会导致数据传输延迟增加。
linger.ms
如果数据迟迟未达到 batch.size,sender 等待 linger.time之后就会发送数据。单位 ms,默认值是 0ms ,表示没有延迟。生产环境建议该值大小为 5-100ms 之间。
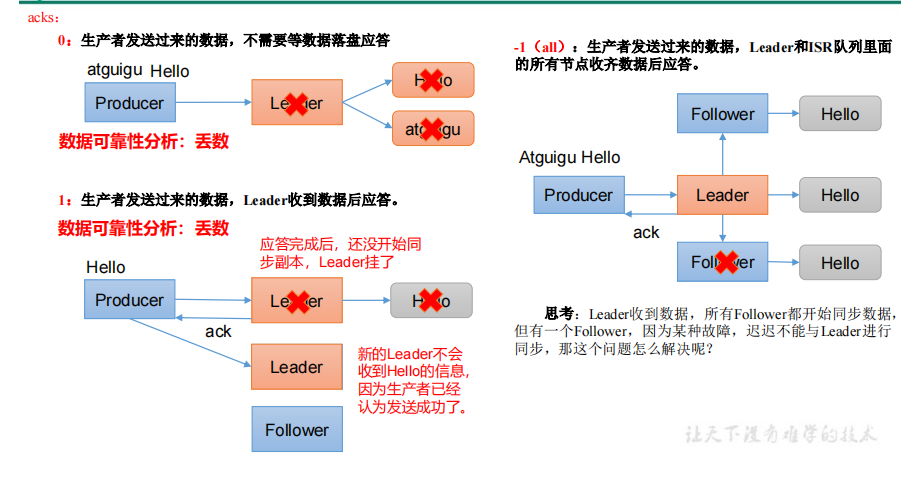
acks
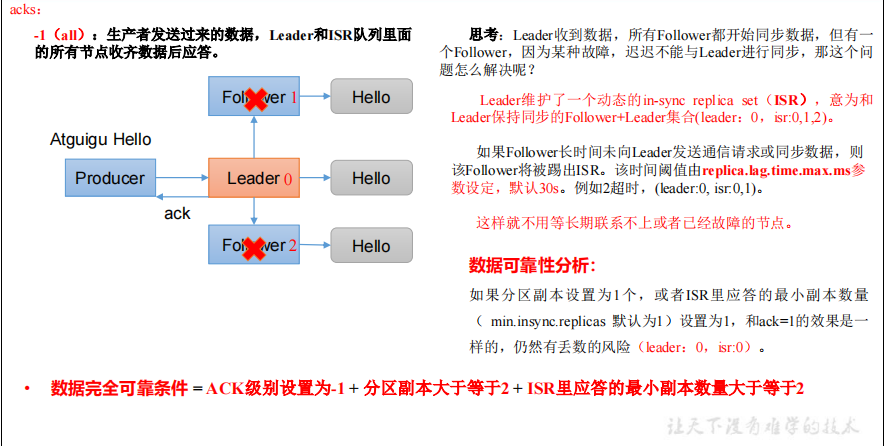
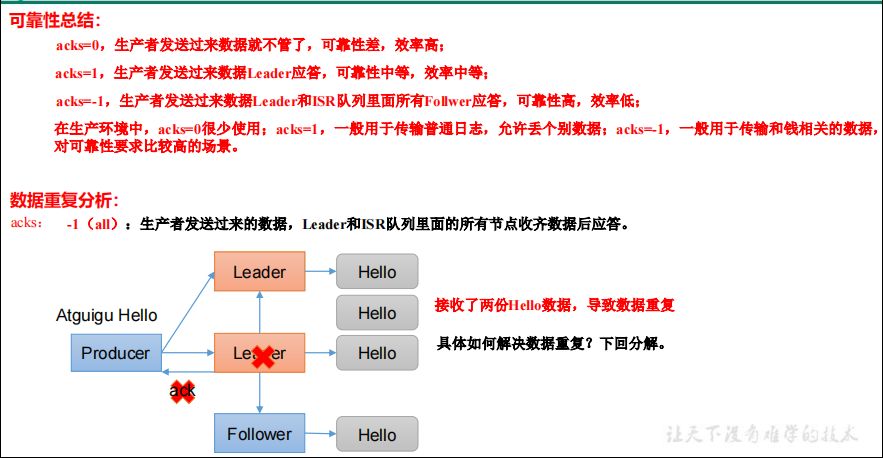
0:生产者发送过来的数据,不需要等数据落盘应答。1:生产者发送过来的数据,Leader 收到数据后应答。-1(all):生产者发送过来的数据,Leader+和 isr 队列里面的所有节点收齐数据后应答。默认值是-1,-1 和all 是等价的。
max.in.flight.requests.per.connection
允许最多没有返回 ack 的次数,默认为 5,开启幂等性要保证该值是 1-5 的数字。
retries
当消息发送出现错误的时候,系统会重发消息。retries表示重试次数。默认是 int 最大值,2147483647。 如果设置了重试,还想保证消息的有序性,需要设置MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION=1否则在重试此失败消息的时候,其他的消息可能发送
retry.backoff.ms
两次重试之间的时间间隔,默认是 100ms。
enable.idempotence
是否开启幂等性,默认 true ,开启幂等性。
compression.type
生产者发送的所有数据的压缩方式。默认是 none ,也就是不压缩。支持压缩类型:none、gzip、snappy、lz4 和 zstd。
3.2 异步发送 API 3.2.1 普通异步发送 1)需求:创建 Kafka 生产者,采用异步的方式发送到 Kafka Broker
2)代码编写
(1)创建工程 kafka
(2)导入依赖
1 2 3 4 5 6 7 <dependencies > <dependency > <groupId > org.apache.kafka</groupId > <artifactId > kafka-clients</artifactId > <version > 3.0.0</version > </dependency > </dependencies >
(3)创建包名:com.atguigu.kafka.producer
(4)编写不带回调函数的 API 代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerRecord;import java.util.Properties;public class CustomProducer public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );"org.apache.kafka.common.serialization.StringSerializer" );"org.apache.kafka.common.serialization.StringSerializer" );new for (int i = 0 ; i < 5 ; i++) {new "first" ,"atguigu " + i));
测试:
①在 hadoop102 上开启 Kafka 消费者。
1 [atguigu@hadoop103 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
②在 IDEA 中执行代码,观察 hadoop102 控制台中是否接收到消息
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
3.2.2 带回调函数的异步发送 回调函数会在 producer 收到 ack 时调用,为异步调用,该方法有两个参数,分别是元数据信息(RecordMetadata)和异常信息(Exception),如果 Exception 为 null,说明消息发送成功,如果 Exception 不为 null,说明消息发送失败。
注意:消息发送失败会自动重试,不需要我们在回调函数中手动重试。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import java.util.Properties;public class CustomProducerCallback public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );new for (int i = 0 ; i < 5 ; i++) {new ProducerRecord<>("first" ,"atguigu " + i), new Callback() {@Override public void onCompletion (RecordMetadata metadata, Exception exception) if (exception == null ) {" 主题: " +"->" + "分区:" + metadata.partition());else {2 );
测试:
①在 hadoop102 上开启 Kafka 消费者。
1 [atguigu@hadoop103 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
②在 IDEA 中执行代码,观察 hadoop102 控制台中是否接收到消息。
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
③在 IDEA 控制台观察回调信息。
1
2
3
4
5
主题:first->分区:0
3.3 同步发送 API
只需在异步发送的基础上,再调用一下 get()方法即可。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerConfig;import org.apache.kafka.clients.producer.ProducerRecord;import java.util.Properties;import java.util.concurrent.ExecutionException;public class CustomProducerSync public static void main (String[] args) throws InterruptedException, ExecutionException new Properties();"hadoop102:9092 " );new KafkaProducer<String, String>(properties);for (int i = 0 ; i < 10 ; i++) {new ProducerRecord<>("first" , "kafka" + i)).get();
测试:
略
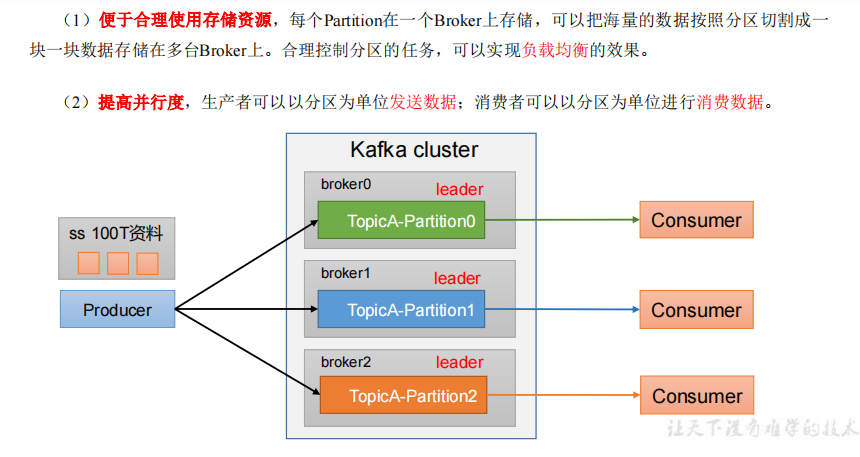
3.4 生产者分区 3.4.1 分区好处
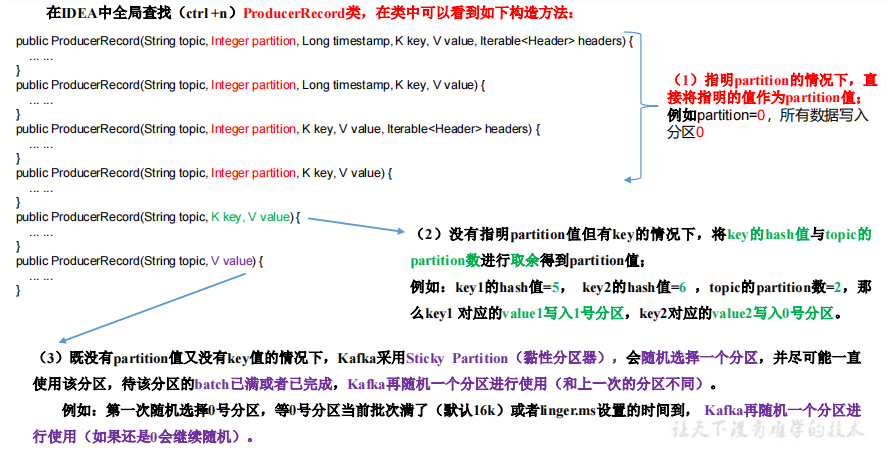
3.4.2 生产者发送消息的分区策略 1)默认的分区器 DefaultPartitioner
在 IDEA 中 ctrl +n,全局查找 DefaultPartitioner。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 public class DefaultPartitioner implements Partitioner
2)案例一
将数据发往指定 partition 的情况下 ,例如,将所有数据发往分区 1 中。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import org.apache.kafka.common.serialization.StringSerializer;import java.util.Properties;public class CustomProducerCallbackPartitions public static void main (String[] args) new Properties();"hadoop102:9092 " );new for (int i = 0 ; i < 5 ; i++) {new ProducerRecord<>("first" ,1 , "" , "atguigu " + i), new Callback() {@Override public void onCompletion (RecordMetadata metadata, Exception e) if (e == null ) {" 主题: " +"->" + "分区:" + metadata.partition()else {
测试:
①在 hadoop102 上开启 Kafka 消费者。
1
2
[atguigu@hadoop103 kafka]$ bin/kafka-console-consumer.sh --
②在 IDEA 中执行代码,观察 hadoop102 控制台中是否接收到消息。
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
③在 IDEA 控制台观察回调信息。
主题:first->分区:1
主题:first->分区:1
主题:first->分区:1
主题:first->分区:1
主题:first->分区:1
3)案例二
没有指明 partition 值但有 key 的情况下 ,将 key 的 hash 值与 topic 的 partition 数进行取余得到 partition 值。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import org.apache.kafka.common.serialization.StringSerializer;import java.util.Properties;public class CustomProducerCallback public static void main (String[] args) new Properties();"hadoop102:9092 " );new for (int i = 0 ; i < 5 ; i++) {new ProducerRecord<>("first" ,"a" , "atguigu " + i), new Callback() {@Override public void onCompletion (RecordMetadata metadata, Exception e) if (e == null ) {" 主题: " +"->" + "分区:" + metadata.partition()else {
测试:
①key=”a”时,在控制台查看结果。
主题:first->分区:1
主题:first->分区:1
主题:first->分区:1
主题:first->分区:1
主题:first->分区:1
②key=”b”时,在控制台查看结果。
主题:first->分区:2
主题:first->分区:2
主题:first->分区:2
主题:first->分区:2
主题:first->分区:2
③key=”f”时,在控制台查看结果。
主题:first->分区:0
主题:first->分区:0
主题:first->分区:0
主题:first->分区:0
主题:first->分区:0
3.4.3 自定义分区器 如果研发人员可以根据企业需求,自己重新实现分区器。
1)需求
例如我们实现一个分区器实现,发送过来的数据中如果包含 atguigu,就发往 0 号分区,不包含 atguigu,就发往 1 号分区
2)实现步骤
(1)定义类实现 Partitioner 接口。
(2)重写 partition()方法。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import org.apache.kafka.common.Cluster;import org.apache.kafka.common.serialization.StringSerializer;import java.util.Map;public class MyPartitioner implements Partitioner @Override public int partition (String topic, Object key, byte [] keyBytes, Object value, byte [] valueBytes, Cluster cluster) int partition;if (msgValue.contains("atguigu" )) {0 ;else {1 ;return partition;@Override public void close () @Override public void configure (Map<String, ?> configs)
(3)使用分区器的方法,在生产者的配置中添加分区器参数。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.*;import org.apache.kafka.common.serialization.StringSerializer;import java.util.Properties;public class CustomProducerCallbackPartitions public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );"com.atgui gu.kafka.producer.MyPartitioner" );new for (int i = 0 ; i < 5 ; i++) {new ProducerRecord<>("first" ,"atguigu " + i), new Callback() {@Override public void onCompletion (RecordMetadata metadata, Exception e) if (e == null ) {" 主题: " +"->" + "分区:" + metadata.partition()else {
(4)测试
①在 hadoop102 上开启 Kafka 消费者。
1 [atguigu@hadoop103 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
②在 IDEA 控制台观察回调信息。
1 2 3 4 5 主题:first ->分区:0 first ->分区:0 first ->分区:0 first ->分区:0 first ->分区:0
3.5 生产经验——生产者如何提高吞吐量
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerConfig;import org.apache.kafka.clients.producer.ProducerRecord;import java.util.Properties;public class CustomProducerParameters public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );"org.apache.kafka.common.serialization.StringSerializer" );"org.apache.kafka.common.serialization.StringSerializer" );16384 );1 );33554432 );"snappy" );new for (int i = 0 ; i < 5 ; i++) {new "first" ,"atguigu " + i));
测试:
①在 hadoop102 上开启 Kafka 消费者。
1 [atguigu@hadoop103 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
②在 IDEA 中执行代码,观察 hadoop102 控制台中是否接收到消息。
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
3.6 生产经验——数据可靠性 0)回顾发送流程
1)ack 应答原理
2)代码配置
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerConfig;import org.apache.kafka.clients.producer.ProducerRecord;import org.apache.kafka.common.serialization.StringSerializer;import java.util.Properties;public class CustomProducerAck public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );"all" );3 );new for (int i = 0 ; i < 5 ; i++) {new "first" ,"atguigu " + i));
3.7 生产经验——数据去重 3.7.1 数据传递语义
至少一次(At Least Once) = ACK级别设置为-1 + 分区副本大于等于2 + ISR里应答的最小副本数量大于等于2
最多一次(At Most Once)= ACK级别设置为0
总结:
At Least Once可以保证数据不丢失,但是不能保证数据不重复;
At Most Once可以保证数据不重复,但是不能保证数据不丢失。
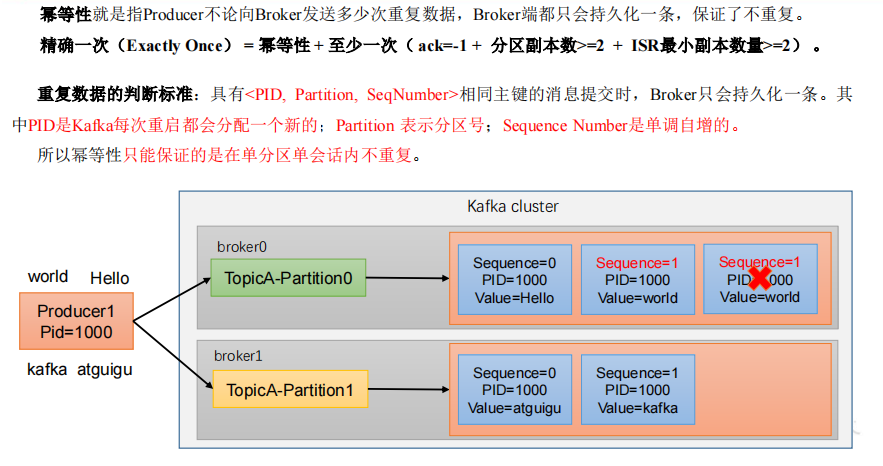
精确一次(Exactly Once): 对于一些非常重要的信息,比如和钱相关的数据,要求数据既不能重复也不丢失。
Kafka 0.11版本以后,引入了一项重大特性:幂等性和事务。
3.7.2 幂等性 1)幂等性原理
2)如何使用幂等性
开启参数 enable.idempotence 默认为 true,false 关闭
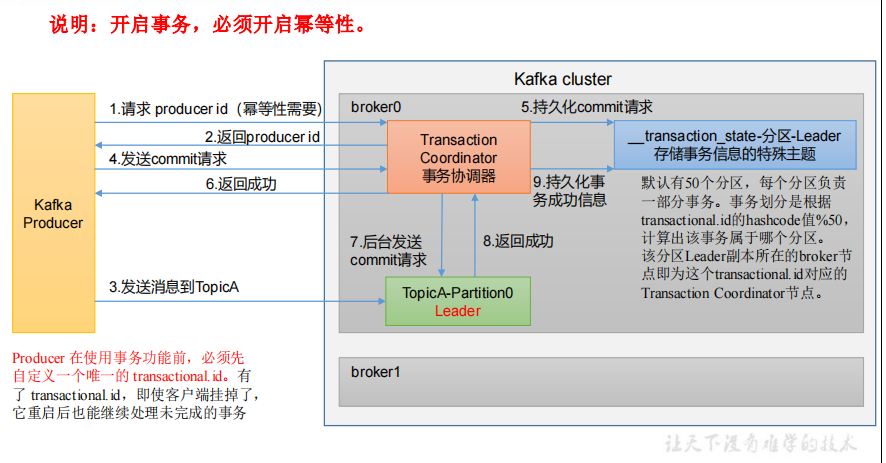
3.7.3 生产者事务 1)Kafka 事务原理
2)Kafka 的事务一共有如下 5 个 API
1 2 3 4 5 6 7 8 9 10 11 12 void initTransactions () void beginTransaction () throws ProducerFencedExceptionvoid sendOffsetsToTransaction (Map<TopicPartition, OffsetAndMetadata> offsets, String consumerGroupId) throws ProducerFencedException ;void commitTransaction () throws ProducerFencedExceptionvoid abortTransaction () throws ProducerFencedException
3)单个 Producer,使用事务保证消息的仅一次发送
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
package com.atguigu.kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerConfig;import org.apache.kafka.clients.producer.ProducerRecord;import org.apache.kafka.common.serialization.StringSerializer;import java.util.Properties;public class CustomProducerTransactions public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );"transaction_id_0" );new KafkaProducer<String, String>(properties);try {for (int i = 0 ; i < 5 ; i++) {new ProducerRecord<>("first" , "atguigu " + i));catch (Exception e) {finally {
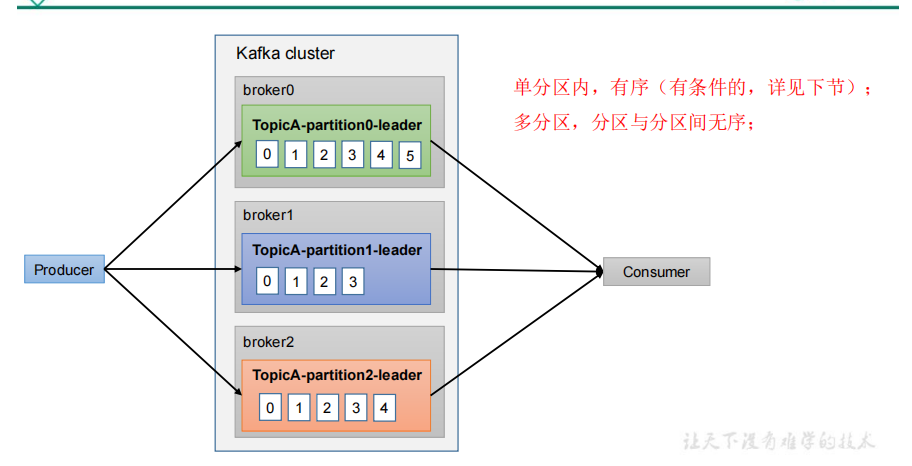
3.8 生产经验——数据有序
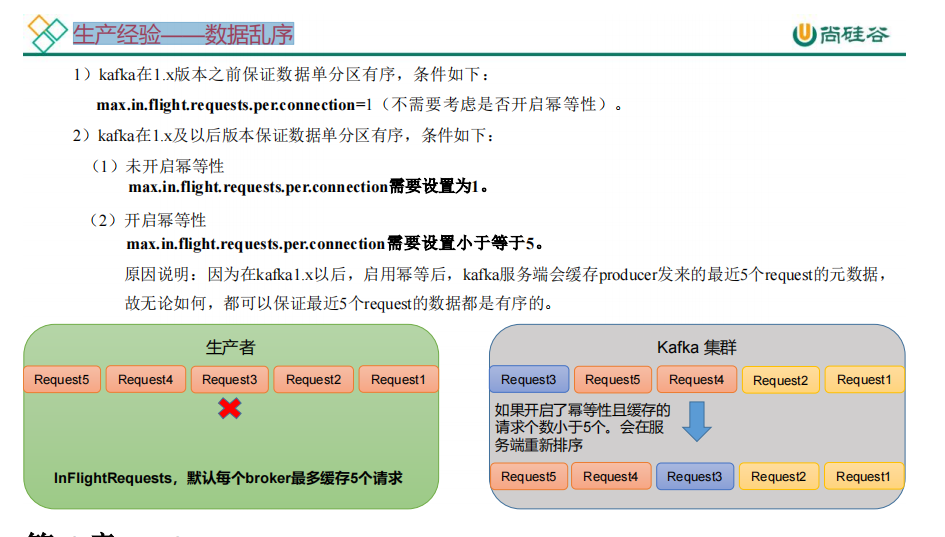
3.9 生产经验——数据乱序
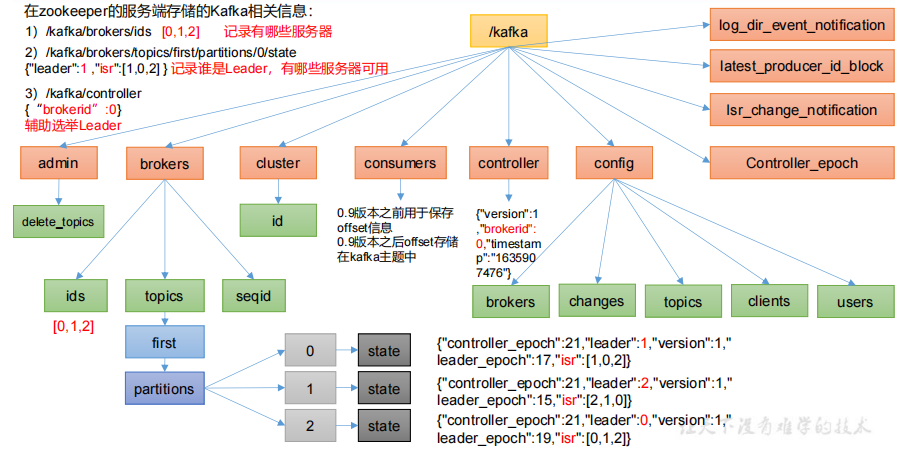
第 4 章 Kafka Broker 4.1 Kafka Broker 工作流程 4.1.1 Zookeeper 存储的 Kafka 信息 (1)启动 Zookeeper 客户端。
1 [atguigu@hadoop102 zookeeper-3.5.7]$ bin/zkCli.sh
(2)通过 ls 命令可以查看 kafka 相关信息。
1 [zk: localhost:2181(CONNECTED) 2] ls /kafka
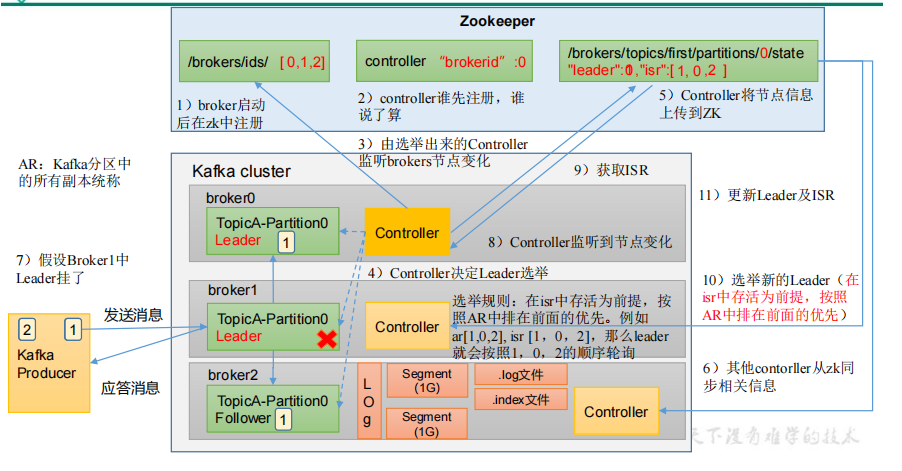
4.1.2 Kafka Broker 总体工作流程
1)模拟 Kafka 上下线,Zookeeper 中数据变化
(1)查看/kafka/brokers/ids 路径上的节点。
1
2
[zk: localhost:2181(CONNECTED) 2] ls /kafka/brokers/ids
(2)查看/kafka/controller 路径上的数据。
1
2
[zk: localhost:2181(CONNECTED) 15] get /kafka/controller
(3)查看/kafka/brokers/topics/first/partitions/0/state 路径上的数据。
1
2
[zk: localhost:2181(CONNECTED) 16] get /kafka/brokers/topics/first/partitions/0/state
(4)停止 hadoop104 上的 kafka。
1 [atguigu@hadoop104 kafka]$ bin/kafka-server-stop.sh
(5)再次查看/kafka/brokers/ids 路径上的节点。
1
2
[zk: localhost:2181(CONNECTED) 3] ls /kafka/brokers/ids
(6)再次查看/kafka/controller 路径上的数据。
1
2
[zk: localhost:2181(CONNECTED) 15] get /kafka/controller
(7)再次查看/kafka/brokers/topics/first/partitions/0/state 路径上的数据。
1
2
[zk: localhost:2181(CONNECTED) 16] get /kafka/brokers/topics/first/partitions/0/state
(8)启动 hadoop104 上的 kafka。
1 [atguigu@hadoop104 kafka]$ bin/kafka-server-start.sh -daemon ./config/server.properties
(9)再次观察(1)、(2)、(3)步骤中的内容。
4.1.3 Broker 重要参数
参数名称
描述
replica.lag.time.max.ms
ISR 中,如果 Follower 长时间未向 Leader 发送通信请求或同步数据,则该 Follower 将被踢出 ISR。该时间阈值,默认 30s。
auto.leader.rebalance.enable
默认是 true 。 自动 Leader Partition 平衡。
leader.imbalance.per.broker.percentage
默认是 10%。 每个 broker 允许的不平衡的 leader的比率。如果每个 broker 超过了这个值,控制器会触发 leader 的平衡。
leader.imbalance.check.interval.seconds
默认值 300 秒 。检查 leader 负载是否平衡的间隔时间。
log.segment.bytes
Kafka 中 log 日志是分成一块块存储的,此配置是指 log 日志划分 成块的大小,默认值 1G。
log.index.interval.bytes
默认 4kb ,kafka 里面每当写入了 4kb 大小的日志(.log),然后就往 index 文件里面记录一个索引。
log.retention.hours
Kafka 中数据保存的时间,默认 7 天。
log.retention.minutes
Kafka 中数据保存的时间,分钟级别,默认关闭。
log.retention.ms
Kafka 中数据保存的时间,毫秒级别,默认关闭。
log.retention.check.interval.ms
检查数据是否保存超时的间隔,默认是 5 分钟。
log.retention.bytes
默认等于-1,表示无穷大 。超过设置的所有日志总大小,删除最早的 segment。
log.cleanup.policy
默认是 delete ,表示所有数据启用删除策略;如果设置值为 compact,表示所有数据启用压缩策略。
num.io.threads
默认是 8 。负责写磁盘的线程数。整个参数值要占总核数的 50%。
num.replica.fetchers
副本拉取线程数,这个参数占总核数的 50%的 1/3
num.network.threads
默认是 3 。数据传输线程数,这个参数占总核数的50%的 2/3 。
log.flush.interval.messages
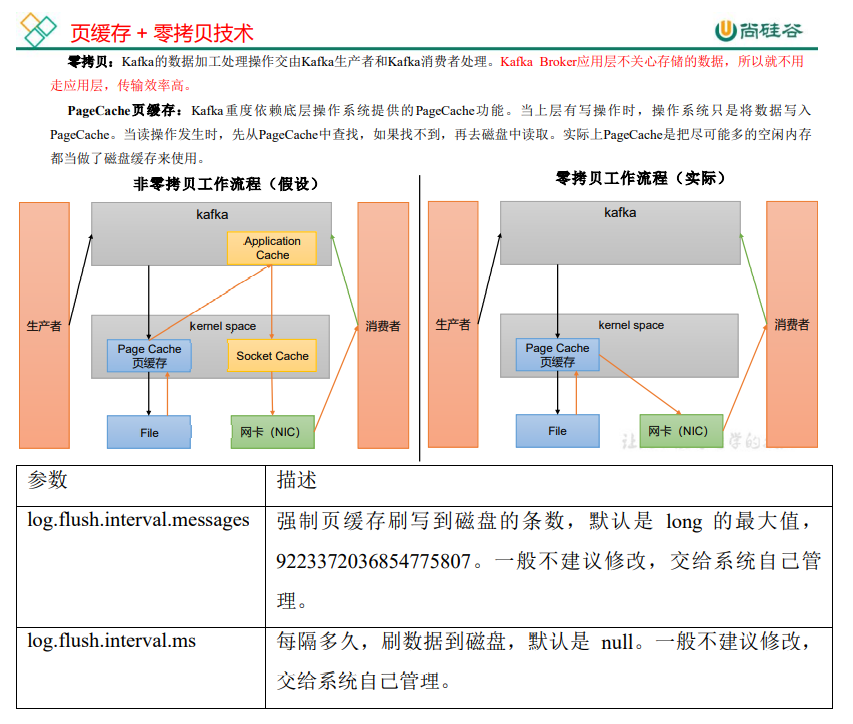
强制页缓存刷写到磁盘的条数,默认是 long 的最大值,9223372036854775807。一般不建议修改,交给系统自己管理。
log.flush.interval.ms
每隔多久,刷数据到磁盘,默认是 null。一般不建 议修改,交给系统自己管理。
4.2 生产经验——节点服役和退役 4.2.1 服役新节点 1)新节点准备
(1)关闭 hadoop104,并右键执行克隆操作。
(2)开启 hadoop105,并修改 IP 地址。
1
2
3
4
5
6
7
8
9
10
11
[root@hadoop104 ~]# vim /etc/sysconfig/network-scripts/ifcfgens33
(3)在 hadoop105 上,修改主机名称为 hadoop105。
1
2
[root@hadoop104 ~]# vim /etc/hostname
(4)重新启动 hadoop104、hadoop105。
(5)修改 haodoop105 中 kafka 的 broker.id 为 3。
(6)删除 hadoop105 中 kafka 下的 datas 和 logs。
1 [atguigu@hadoop105 kafka]$ rm -rf datas/* logs/*
(7)启动 hadoop102、hadoop103、hadoop104 上的 kafka 集群。
1
2
[atguigu@hadoop102 ~]$ zk.sh start
(8)单独启动 hadoop105 中的 kafka。
1
2
[atguigu@hadoop105 kafka]$ bin/kafka-server-start.sh -
2)执行负载均衡操作
(1)创建一个要均衡的主题。
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ vim topics-to-move.json
(2)生成一个负载均衡的计划。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
(3)创建副本存储计划(所有副本存储在 broker0、broker1、broker2、broker3 中)。
1
2
3
4
5
6
[atguigu@hadoop102 kafka]$ vim increase-replication-factor.json
(4)执行副本存储计划。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
(5)验证副本存储计划。
1
2
3
4
5
6
7
8
9
10
11
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
4.2.2 退役旧节点 1)执行负载均衡操作
先按照退役一台节点,生成执行计划 ,然后按照服役时操作流程执行负载均衡。
(1)创建一个要均衡的主题。
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ vim topics-to-move.json
(2)创建执行计划。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
(3)创建副本存储计划(所有副本存储在 broker0、broker1、broker2 中)。
1
2
3
4
5
6
7
[atguigu@hadoop102 kafka]$ vim increase-replication-factor.json
(4)执行副本存储计划。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
(5)验证副本存储计划。
1
2
3
4
5
6
7
8
9
10
11
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
2)执行停止命令
在 hadoop105 上执行停止命令即可。
1 [atguigu@hadoop105 kafka]$ bin/kafka-server-stop.sh
4.3 Kafka 副本 4.3.1 副本基本信息 (1)Kafka 副本作用:提高数据可靠性。
(2)Kafka 默认副本 1 个,生产环境一般配置为 2 个,保证数据可靠性;太多副本会 增加磁盘存储空间,增加网络上数据传输,降低效率。
(3)Kafka 中副本分为:Leader 和 Follower。Kafka 生产者只会把数据发往 Leader, 然后 Follower 找 Leader 进行同步数据。
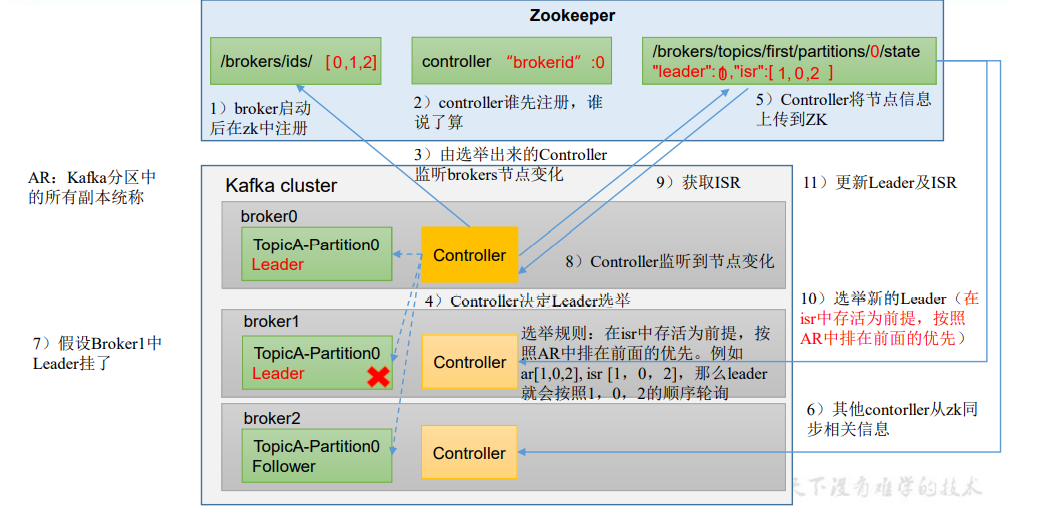
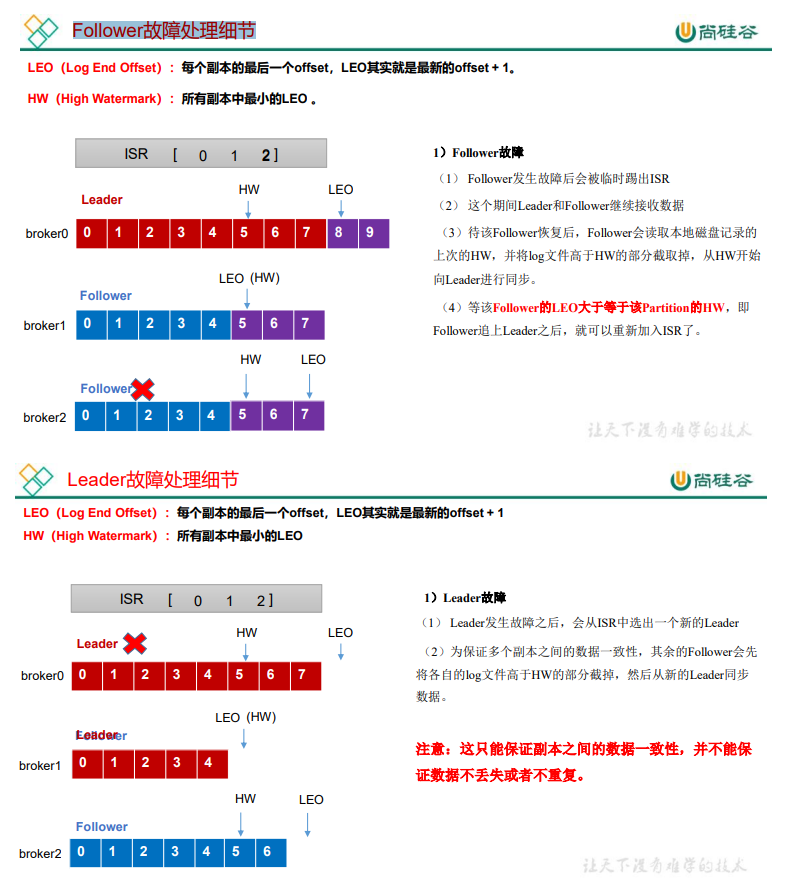
(4)Kafka 分区中的所有副本统称为 AR(Assigned Repllicas)。 AR = ISR + OSR ISR,表示和 Leader 保持同步的 Follower 集合。如果 Follower 长时间未向 Leader 发送通信请求或同步数据,则该 Follower 将被踢出 ISR。该时间阈值由 replica.lag.time.max.ms 参数设定,默认 30s。Leader 发生故障之后,就会从 ISR 中选举新的 Leader。
OSR ,表示 Follower 与 Leader 副本同步时,延迟过多的副本。
4.3.2 Leader 选举流程 Kafka 集群中有一个 broker 的 Controller 会被选举为 Controller Leader,负责管理集群 broker 的上下线 ,所有 topic 的分区副本分配和 Leader 选举 等工作。
Controller 的信息同步工作是依赖于 Zookeeper 的。
(1)创建一个新的 topic,4 个分区,4 个副本
1
2
3
4
5
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
(2)查看 Leader 分布情况
1
2
3
4
5
6
7
8
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --describe --topic atguigu1
(3)停止掉 hadoop105 的 kafka 进程,并查看 Leader 分区情况
1
2
3
4
5
6
7
8
9
[atguigu@hadoop105 kafka]$ bin/kafka-server-stop.sh
(4)停止掉 hadoop104 的 kafka 进程,并查看 Leader 分区情况
1
2
3
4
5
6
7
8
9
10
11
[atguigu@hadoop104 kafka]$ bin/kafka-server-stop.sh
(5)启动 hadoop105 的 kafka 进程,并查看 Leader 分区情况
1
2
3
4
5
6
7
8
9
10
[atguigu@hadoop105 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
(6)启动 hadoop104 的 kafka 进程,并查看 Leader 分区情况
1
2
3
4
5
6
7
8
9
[atguigu@hadoop104 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
(7)停止掉 hadoop103 的 kafka 进程,并查看 Leader 分区情况
1
2
3
4
5
6
7
8
9
10
11
[atguigu@hadoop103 kafka]$ bin/kafka-server-stop.sh
4.3.3 Leader 和 Follower 故障处理细节
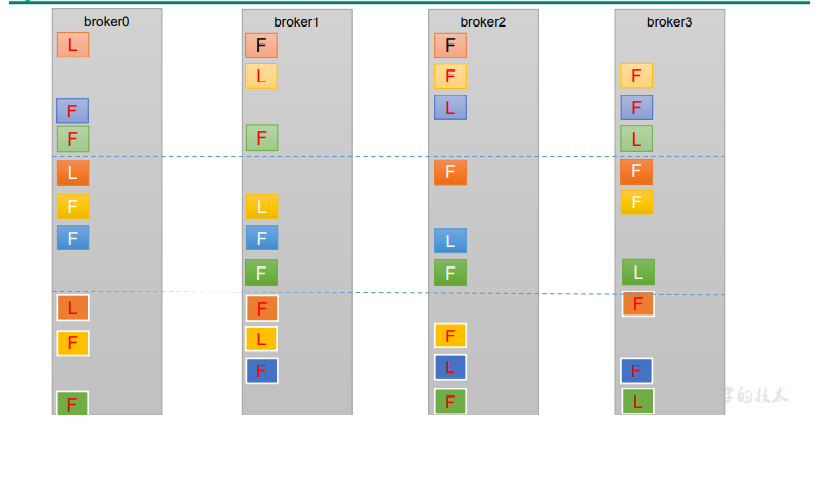
4.3.4 分区副本分配 如果 kafka 服务器只有 4 个节点,那么设置 kafka 的分区数大于服务器台数,在 kafka 底层如何分配存储副本呢?
1)创建 16 分区,3 个副本
(1)创建一个新的 topic,名称为 second。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
(2)查看分区和副本情况。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
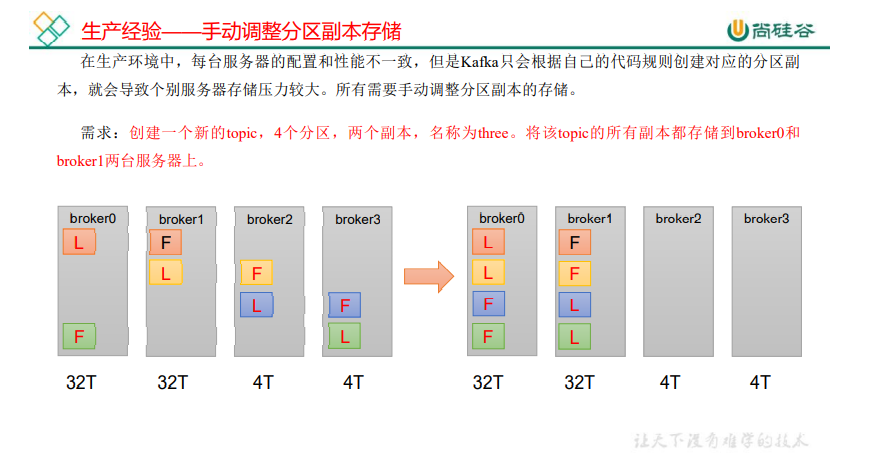
4.3.5 生产经验——手动调整分区副本存储
手动调整分区副本存储的步骤如下:
(1)创建一个新的 topic,名称为 three。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
(2)查看分区副本存储情况。
1
2
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
(3)创建副本存储计划(所有副本都指定存储在 broker0、broker1 中)。
1 [atguigu@hadoop102 kafka]$ vim increase-replication-factor.json
输入如下内容:
1
2
3
4
5
6
7
{
(4)执行副本存储计划。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
(5)验证副本存储计划。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
(6)查看分区副本存储情况。
1
2
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
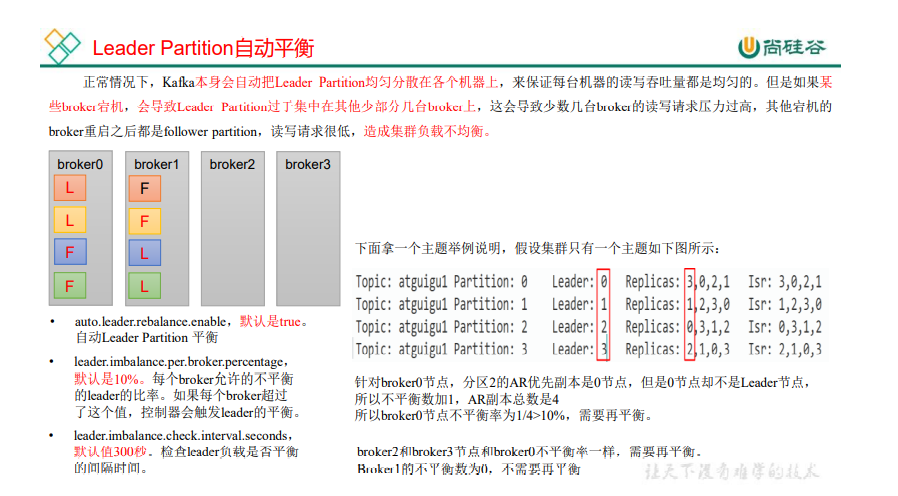
4.3.6 生产经验——Leader Partition 负载平衡
参数名称
描述
auto.leader.rebalance.enable
默认是 true。 自动 Leader Partition 平衡。生产环 境中,leader 重选举的代价比较大,可能会带来 性能影响,建议设置为 false 关闭。
leader.imbalance.per.broker.percentage
默认是 10%。每个 broker 允许的不平衡的 leader 的比率。如果每个 broker 超过了这个值,控制器 会触发 leader 的平衡。
leader.imbalance.check.interval.seconds
默认值 300 秒。检查 leader 负载是否平衡的间隔 时间。
4.3.7 生产经验——增加副本因子 在生产环境当中,由于某个主题的重要等级需要提升,我们考虑增加副本。副本数的 增加需要先制定计划,然后根据计划执行。
1)创建 topic
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
2)手动增加副本存储
(1)创建副本存储计划(所有副本都指定存储在 broker0、broker1、broker2 中)
1 [atguigu@hadoop102 kafka]$ vim increase-replication-factor.json
输入如下内容:
1
2
3
{"version":1,"partitions":[{"topic":"four","partition":0,"replica
(2)执行副本存储计划。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-reassign-partitions.sh --
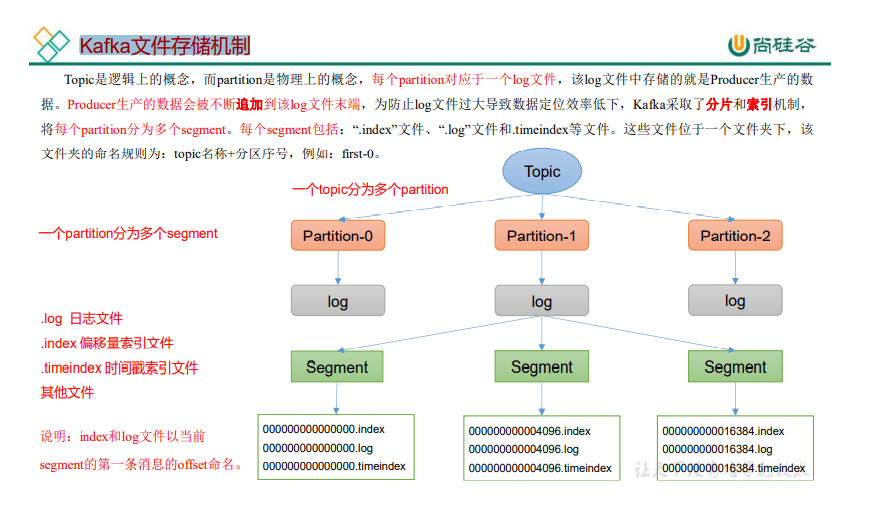
4.4 文件存储 4.4.1 文件存储机制 1)Topic 数据的存储机制
2)思考:Topic 数据到底存储在什么位置?
(1)启动生产者,并发送消息。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-console-producer.sh --> hello world
(2)查看 hadoop102(或者 hadoop103、hadoop104)的/opt/module/kafka/datas/first-1 (first-0、first-2)路径上的文件。
[atguigu@hadoop104 first-1]$ ls
00000000000000000092.index
00000000000000000092.log
00000000000000000092.snapshot
00000000000000000092.timeindex
leader-epoch-checkpoint partition.metadata
(3)直接查看 log 日志,发现是乱码。
1
2
[atguigu@hadoop104 first-1]$ cat 00000000000000000092.log
(4)通过工具查看 index 和 log 信息。
1
2
3
4
5
[atguigu@hadoop104 first-1]$ kafka-run-class.sh kafka.tools.DumpLogSegments
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
[atguigu@hadoop104 first-1]$ kafka-run-class.sh kafka.tools.DumpLogSegments
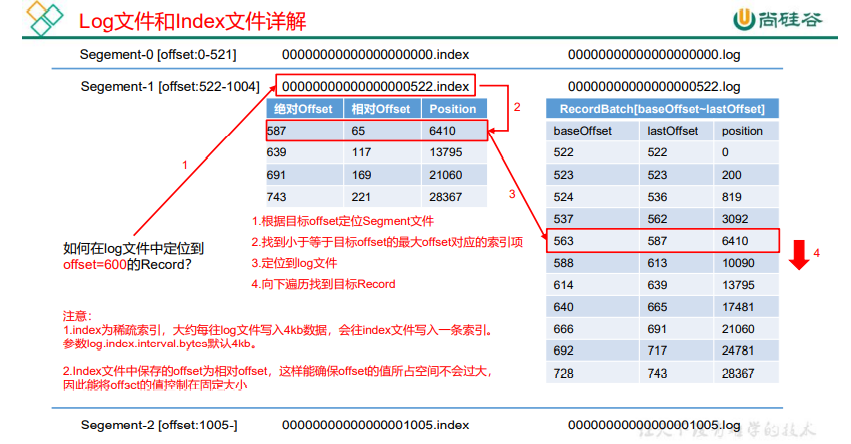
3)index 文件和 log 文件详解
说明:日志存储参数配置
参数
描述
log.segment.bytes
Kafka 中 log 日志是分成一块块存储的,此配置是指 log 日志划分 成块的大小,默认值 1G。
log.index.interval.bytes
默认 4kb ,kafka 里面每当写入了 4kb 大小的日志(.log),然后就 往 index 文件里面记录一个索引。 稀疏索引。
4.4.2 文件清理策略 Kafka 中默认的日志保存时间为 7 天 ,可以通过调整如下参数修改保存时间。
log.retention.hours,最低优先级小时,默认 7 天。
log.retention.minutes,分钟。
log.retention.ms,最高优先级毫秒。
log.retention.check.interval.ms,负责设置检查周期,默认 5 分钟。
那么日志一旦超过了设置的时间,怎么处理呢?
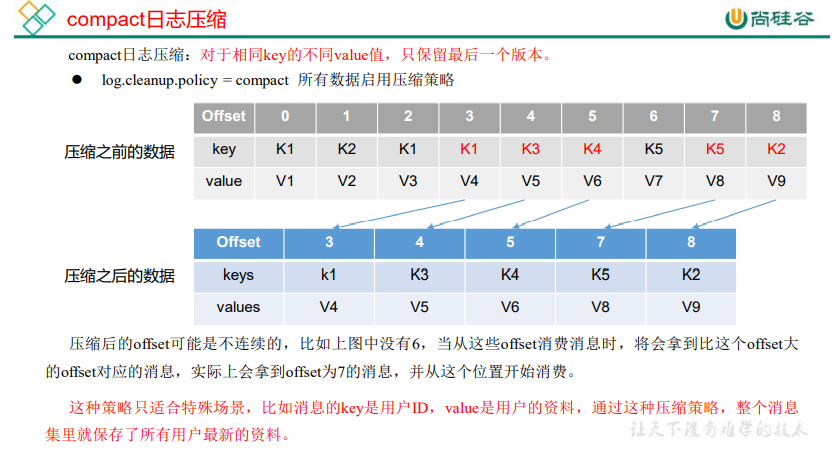
Kafka 中提供的日志清理策略有 delete 和 compact 两种。
1)delete 日志删除:将过期数据删除
log.cleanup.policy = delete 所有数据启用删除策略
(1) 基于时间:默认打开。以 segment 中所有记录中的最大时间戳作为该文件时间戳。
(2)基于大小:默认关闭。超过设置的所有日志总大小,删除最早的 segment。
log.retention.bytes,默认等于-1,表示无穷大。
思考:如果一个 segment 中有一部分数据过期,一部分没有过期,怎么处理?
答案1:看所有数据是否超过7天,超过7天就删掉。不超过7天就保留,通俗就是不求同年同月同日生,但求同年同月同日四
2)compact 日志压缩
4.5 高效读写数据 **1)Kafka 本身是分布式集群,可以采用分区技术,并行度高 **
2)读数据采用稀疏索引,可以快速定位要消费的数据
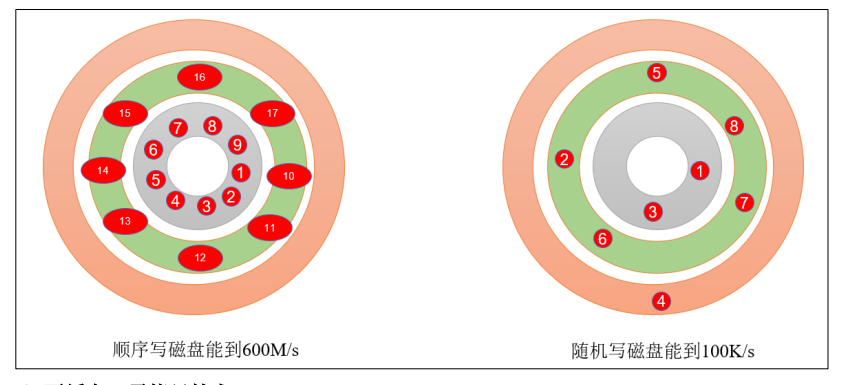
3)顺序写磁盘
Kafka 的 producer 生产数据,要写入到 log 文件中,写的过程是一直追加 到文件末端, 为顺序写。官网有数据表明 ,同样的磁盘,顺序写能到 600M/s,而随机写只有 100K/s。这 与磁盘的机械机构有关,顺序写之所以快,是因为其省去了大量磁头寻址的时间。
4)页缓存 + 零拷贝技术
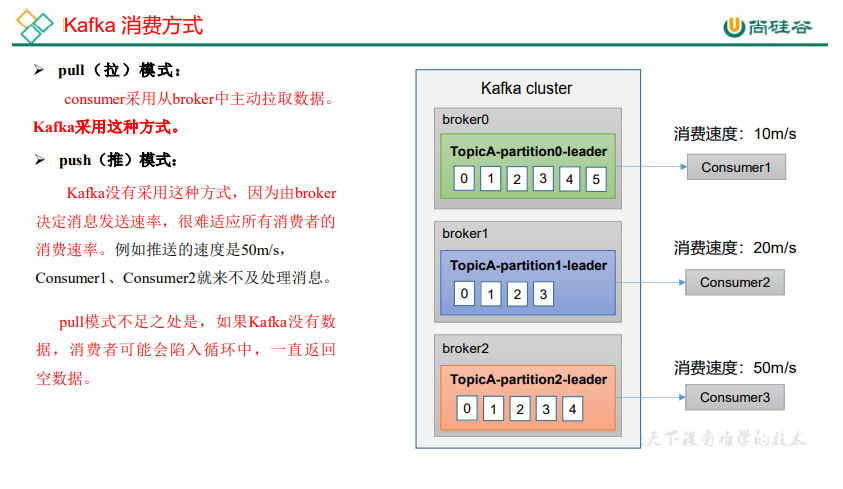
第 5 章 Kafka 消费者 5.1 Kafka 消费方式
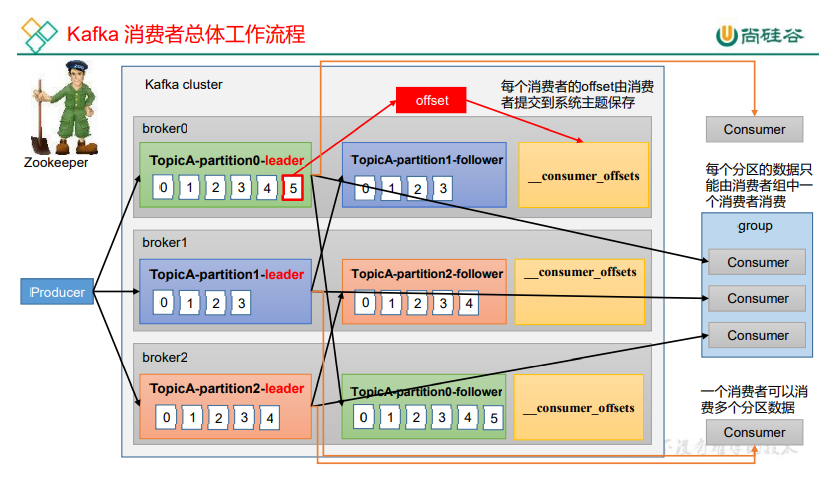
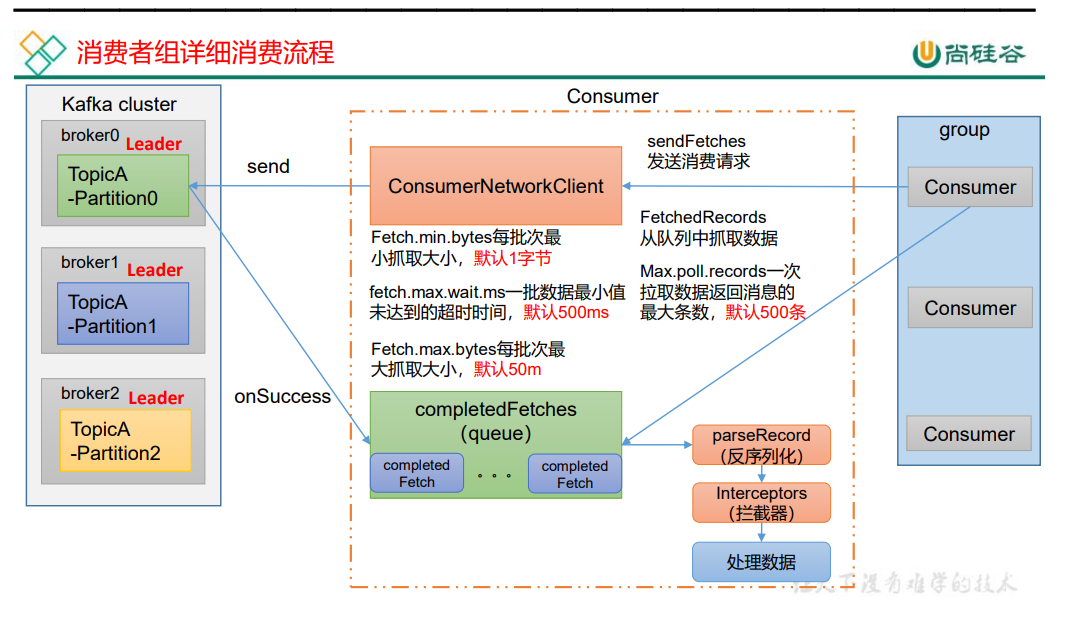
5.2 Kafka 消费者工作流程 5.2.1 消费者总体工作流程
5.2.2 消费者组原理
5.2.3 消费者重要参数
参数名称
描述
bootstrap.servers
向 Kafka 集群建立初始连接用到的 host/port 列表。
key.deserializer 和 value.deserializer
指定接收消息的 key 和 value 的反序列化类型。一定要写全 类名。
group.id
标记消费者所属的消费者组。
enable.auto.commit
默认值为 true ,消费者会自动周期性地向服务器提交偏移 量。
auto.commit.interval.ms
如果设置了 enable.auto.commit 的值为 true, 则该值定义了 消费者偏移量向 Kafka 提交的频率,默认 5s。
auto.offset.reset
当 Kafka 中没有初始偏移量或当前偏移量在服务器中不存在 (如,数据被删除了),该如何处理? earliest:自动重置偏 移量到最早的偏移量。 latest:默认,自动重置偏移量为最 新的偏移量。 none:如果消费组原来的(previous)偏移量 不存在,则向消费者抛异常。 anything:向消费者抛异常。
offsets.topic.num.partitions
__consumer_offsets 的分区数,默认是 50 个分区。
heartbeat.interval.ms
Kafka 消费者和 coordinator 之间的心跳时间,默认 3s 。 该条目的值必须小于 session.timeout.ms ,也不应该高于 session.timeout.ms 的 1/3。
session.timeout.ms
Kafka 消费者和 coordinator 之间连接超时时间,默认 45s 。 超过该值,该消费者被移除,消费者组执行再平衡。
max.poll.interval.ms
消费者处理消息的最大时长,默认是 5 分钟 。超过该值,该 消费者被移除,消费者组执行再平衡。
fetch.min.bytes
默认 1 个字节 。消费者获取服务器端一批消息最小的字节 数。
fetch.max.wait.ms
默认 500ms。如果没有从服务器端获取到一批数据的最小字 节数 。该时间到,仍然会返回数据。
fetch.max.bytes
默认 Default: 52428800(50 m) 。消费者获取服务器端一批 消息最大的字节数。如果服务器端一批次的数据大于该值 (50m)仍然可以拉取回来这批数据,因此,这不是一个绝 对最大值。一批次的大小受 message.max.bytes (broker config)or max.message.bytes (topic config)影响。
max.poll.records
一次 poll 拉取数据返回消息的最大条数,默认是 500 条。
5.3 消费者 API 5.3.1 独立消费者案例(订阅主题) 1)需求:
创建一个独立消费者,消费 first 主题中数据。
注意:在消费者 API 代码中必须配置消费者组 id。命令行启动消费者不填写消费者组 id 会被自动填写随机的消费者组 id。
2)实现步骤
(1)创建包名:com.atguigu.kafka.consumer
(2)编写代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import java.time.Duration;import java.util.ArrayList;import java.util.Properties;public class CustomConsumer public static void main (String[] args) new Properties();"hadoop102:9092" );"test" );new new ArrayList<>();"first" );while (true ) {1 ));for (ConsumerRecord<String, String> consumerRecord :
3)测试
(1)在 IDEA 中执行消费者程序。
(2)在 Kafka 集群控制台,创建 Kafka 生产者,并输入数据。
1
2
3
[atguigu@hadoop102 kafka]$ bin/kafka-console-producer.sh --> hello
(3)在 IDEA 控制台观察接收到的数据。
1
2
3
4
ConsumerRecord(topic = first, partition = 1, leaderEpoch = 3,
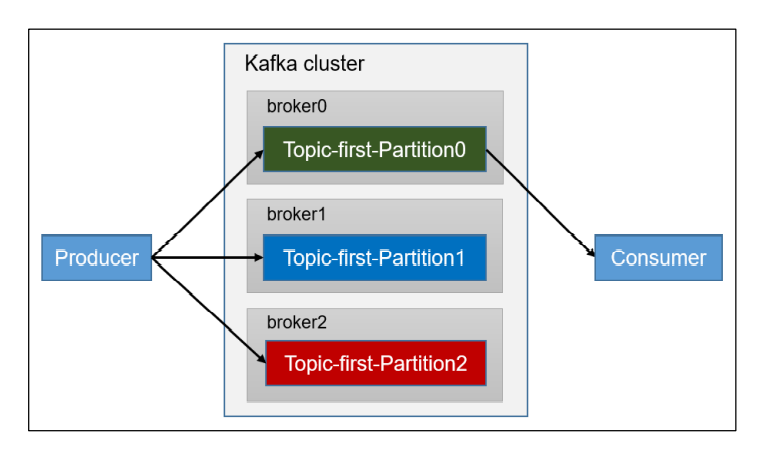
5.3.2 独立消费者案例(订阅分区) 1)需求:创建一个独立消费者,消费 first 主题 0 号分区的数据。
2)实现步骤
(1)代码编写。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import org.apache.kafka.common.TopicPartition;import java.time.Duration;import java.util.ArrayList;import java.util.Arrays;import java.util.Properties;public class CustomConsumerPartition public static void main (String[] args) new Properties();"hadoop102 :9092" );"test" );new new new TopicPartition("first" , 0 ));while (true ){1 ));for (ConsumerRecord<String, String> consumerRecord :
3)测试
(1)在 IDEA 中执行消费者程序。
(2)在 IDEA 中执行生产者程序 CustomProducerCallback()在控制台观察生成几个 0 号 分区的数据。
1
2
3
4
5
first 0 381
(3)在 IDEA 控制台,观察接收到的数据,只能消费到 0 号分区数据表示正确。
1
2
3
4
5
6
7
8
9
10
ConsumerRecord(topic = first, partition = 0, leaderEpoch = 14,
5.3.3 消费者组案例 1)需求:测试同一个主题的分区数据,只能由一个消费者组中的一个消费。
2)案例实操
(1)复制一份基础消费者的代码,在 IDEA 中同时启动,即可启动同一个消费者组中 的两个消费者。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import java.time.Duration;import java.util.ArrayList;import java.util.Properties;public class CustomConsumer1 public static void main (String[] args) new Properties();"hadoop102:9092" );"test" );new new ArrayList<>();"first" );while (true ) {1 ));for (ConsumerRecord<String, String> consumerRecord :
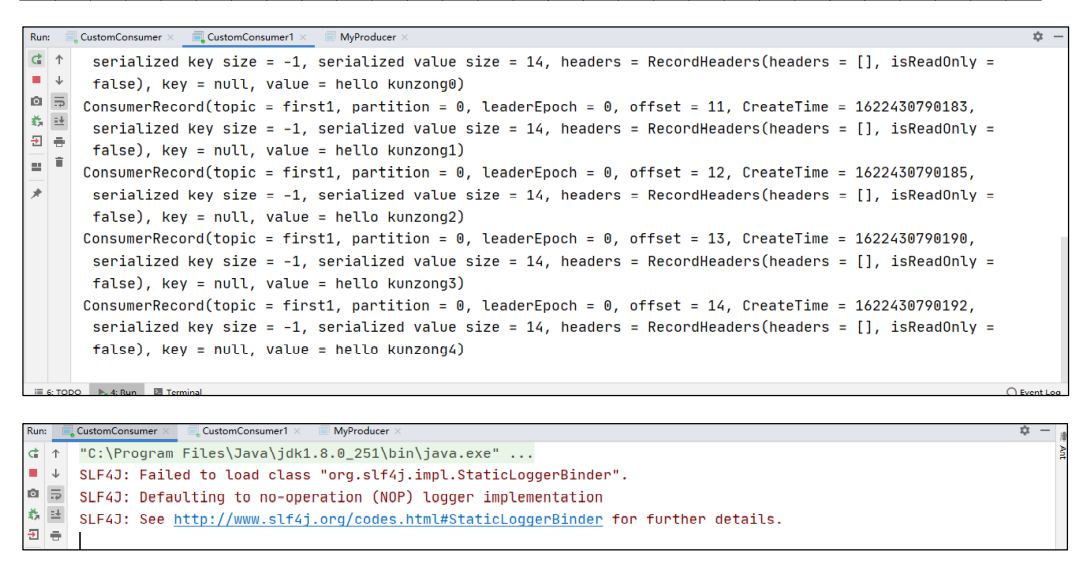
(2)启动代码中的生产者发送消息,在 IDEA 控制台即可看到两个消费者在消费不同 分区的数据(如果只发生到一个分区,可以在发送时增加延迟代码 Thread.sleep(2);)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
ConsumerRecord(topic = first, partition = 0, leaderEpoch = 2,
(3)重新发送到一个全新的主题中,由于默认创建的主题分区数为 1,可以看到只能 有一个消费者消费到数据。
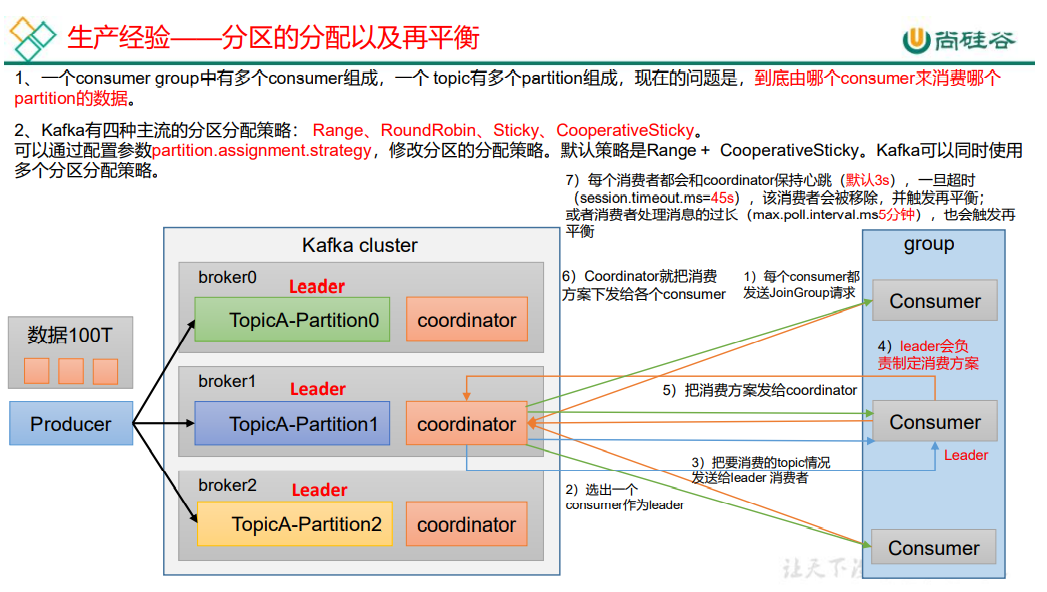
5.4 生产经验——分区的分配以及再平衡
参数名称
描述
heartbeat.interval.ms
Kafka 消费者和 coordinator 之间的心跳时间,默认 3s 。 该条目的值必须小于 session.timeout.ms,也不应该高于 session.timeout.ms 的 1/3。
session.timeout.ms
Kafka 消费者和 coordinator 之间连接超时时间,默认 45s 。超 过该值,该消费者被移除,消费者组执行再平衡。
max.poll.interval.ms
消费者处理消息的最大时长,默认是 5 分钟 。超过该值,该 消费者被移除,消费者组执行再平衡。
partition.assignment.strategy
消 费 者 分 区 分 配 策 略 , 默 认 策 略 是 Range +CooperativeSticky。Kafka 可以同时使用多个分区分配策略。 可 以 选 择 的 策 略 包 括 : Range 、 RoundRobin 、 Sticky 、 CooperativeSticky
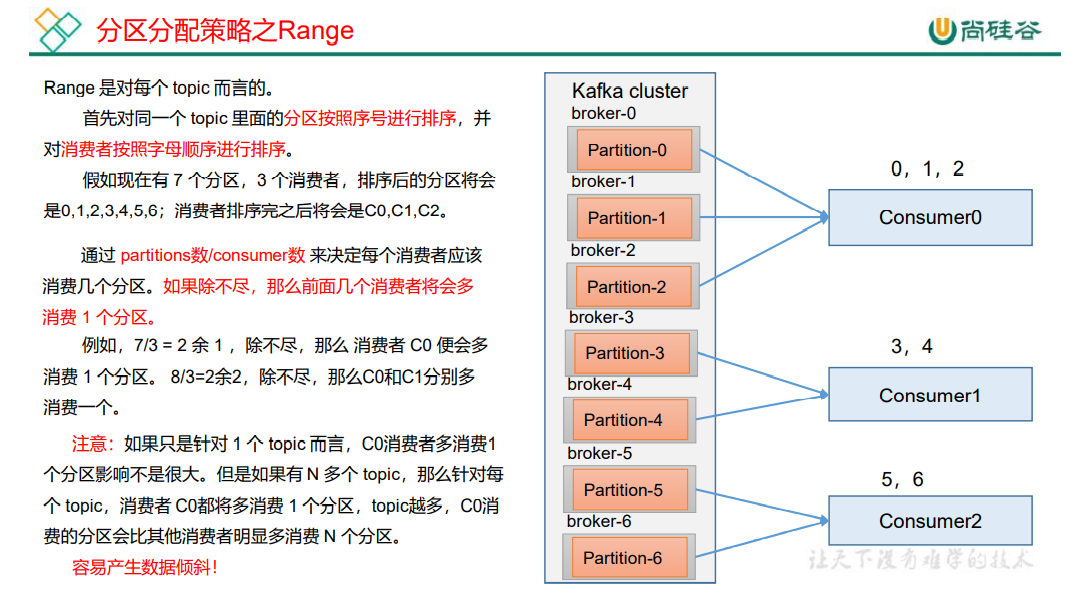
5.4.1 Range 以及再平衡 1)Range 分区策略原理
2)Range 分区分配策略案例
(1)修改主题 first 为 7 个分区。
1
2
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
注意:分区数可以增加,但是不能减少。
(2)复制 CustomConsumer 类,创建 CustomConsumer2。这样可以由三个消费者 CustomConsumer、CustomConsumer1、CustomConsumer2 组成消费者组,组名都为“test”, 同时启动 3 个消费者。
(3)启动 CustomProducer 生产者,发送 500 条消息,随机发送到不同的分区。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
package com.atguigu.kafka.producer;public class CustomProducer public static void main (String[] args) throws InterruptedException {new Properties();"hadoop102:9092" );new for (int i = 0 ; i < 7 ; i++) {new ProducerRecord<>("first" , i,"test" , "atguigu" ));
说明:Kafka 默认的分区分配策略就是 Range + CooperativeSticky,所以不需要修改策 略。
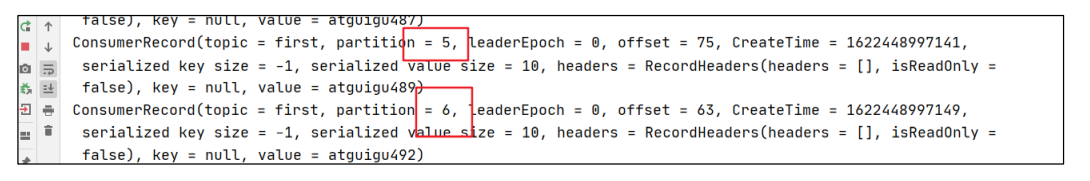
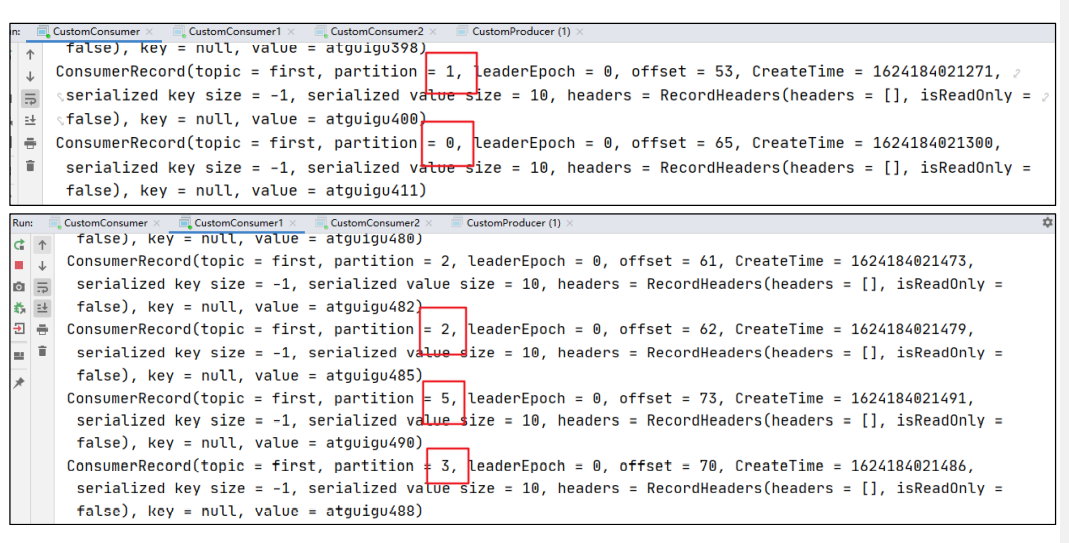
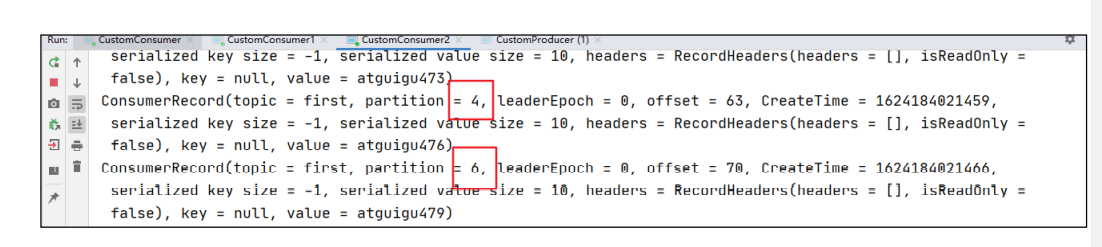
(4)观看 3 个消费者分别消费哪些分区的数据。
3)Range 分区分配再平衡案例
(1)停止掉 0 号消费者,快速重新发送消息观看结果(45s 以内,越快越好)。
说明:0 号消费者挂掉后,消费者组需要按照超时时间 45s 来判断它是否退出,所以需 要等待,时间到了 45s 后,判断它真的退出就会把任务分配给其他 broker 执行。
(2)再次重新发送消息观看结果(45s 以后)。
1 号消费者:消费到 0、1、2、3 号分区数据。
2 号消费者:消费到 4、5、6 号分区数据。
说明:消费者 0 已经被踢出消费者组,所以重新按照 range 方式分配。
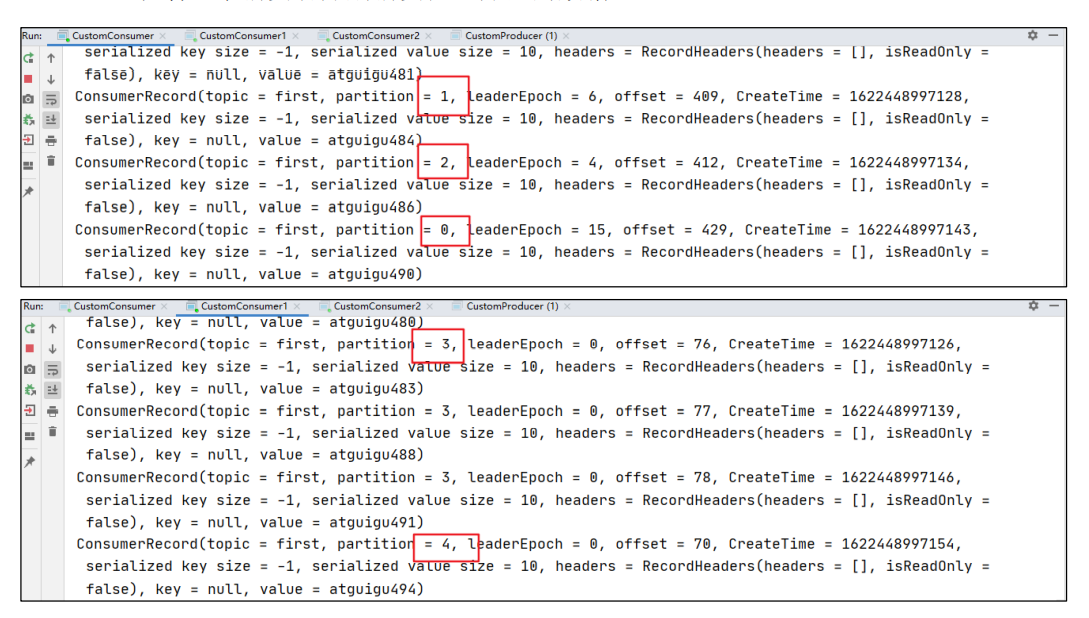
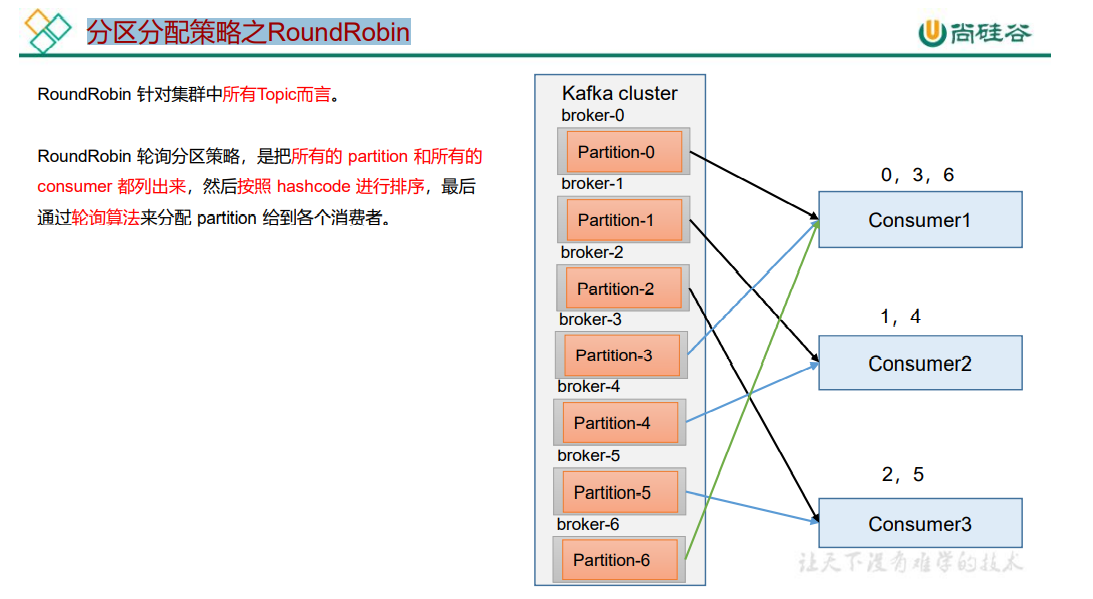
5.4.2 RoundRobin 以及再平衡 1)RoundRobin 分区策略原理
2)RoundRobin 分区分配策略案例
(1)依次在 CustomConsumer、CustomConsumer1、CustomConsumer2 三个消费者代 码中修改分区分配策略为 RoundRobin。
1
2
3
// 修改分区分配策略
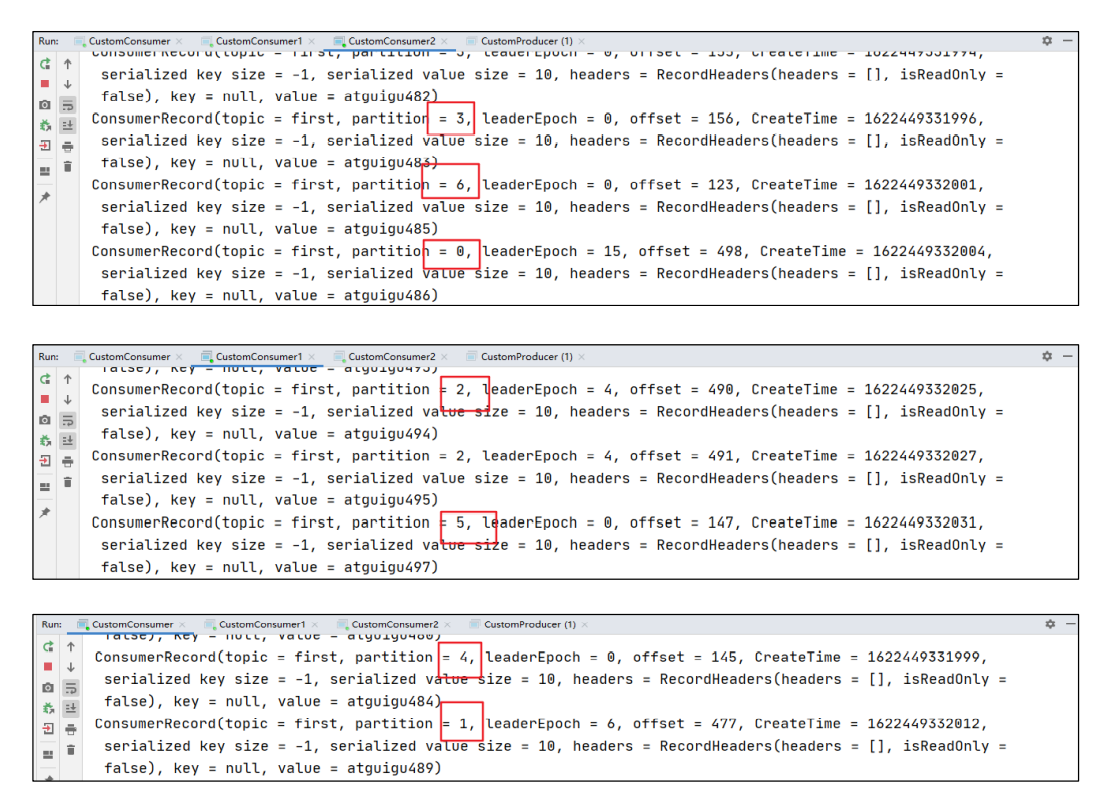
(2)重启 3 个消费者,重复发送消息的步骤,观看分区结果。
3)RoundRobin 分区分配再平衡案例
(1)停止掉 0 号消费者,快速重新发送消息观看结果(45s 以内,越快越好)。
1 号消费者:消费到 2、5 号分区数据
2 号消费者:消费到 4、1 号分区数据
0 号消费者的任务会按照 RoundRobin 的方式,把数据轮询分成 0 、6 和 3 号分区数据 , 分别由 1 号消费者或者 2 号消费者消费。
说明:0 号消费者挂掉后,消费者组需要按照超时时间 45s 来判断它是否退出,所以需 要等待,时间到了 45s 后,判断它真的退出就会把任务分配给其他 broker 执行。
(2)再次重新发送消息观看结果(45s 以后)。
1 号消费者:消费到 0、2、4、6 号分区数据
2 号消费者:消费到 1、3、5 号分区数据
说明:消费者 0 已经被踢出消费者组,所以重新按照 RoundRobin 方式分配。
5.4.3 Sticky 以及再平衡 粘性分区定义:可以理解为分配的结果带有“粘性的”。即在执行一次新的分配之前, 考虑上一次分配的结果,尽量少的调整分配的变动,可以节省大量的开销。
粘性分区是 Kafka 从 0.11.x 版本开始引入这种分配策略,首先会尽量均衡的放置分区 到消费者上面 ,在出现同一消费者组内消费者出现问题的时候,会尽量保持原有分配的分 区不变化。
1)需求
设置主题为 first,7 个分区;准备 3 个消费者,采用粘性分区策略,并进行消费,观察 消费分配情况。然后再停止其中一个消费者,再次观察消费分配情况。
2)步骤
(1)修改分区分配策略为粘性。 注意:3 个消费者都应该注释掉,之后重启 3 个消费者,如果出现报错,全部停止等 会再重启,或者修改为全新的消费者组。
1 2 3 4 5 6 new ArrayList<>();"org.apache.kafka.clients.consumer.StickyAssignor" );
(2)使用同样的生产者发送 500 条消息。
可以看到会尽量保持分区的个数近似划分分区
3)Sticky 分区分配再平衡案例
(1)停止掉 0 号消费者,快速重新发送消息观看结果(45s 以内,越快越好)。
1 号消费者:消费到 2、5、3 号分区数据。
2 号消费者:消费到 4、6 号分区数据。
0 号消费者的任务会按照粘性规则,尽可能均衡的随机分成 0 和 1 号分区数据,分别 由 1 号消费者或者 2 号消费者消费。
说明:0 号消费者挂掉后,消费者组需要按照超时时间 45s 来判断它是否退出,所以需 要等待,时间到了 45s 后,判断它真的退出就会把任务分配给其他 broker 执行。
(2)再次重新发送消息观看结果(45s 以后)。
1 号消费者:消费到 2、3、5 号分区数据。
2 号消费者:消费到 0、1、4、6 号分区数据。
说明:消费者 0 已经被踢出消费者组,所以重新按照粘性方式分配。
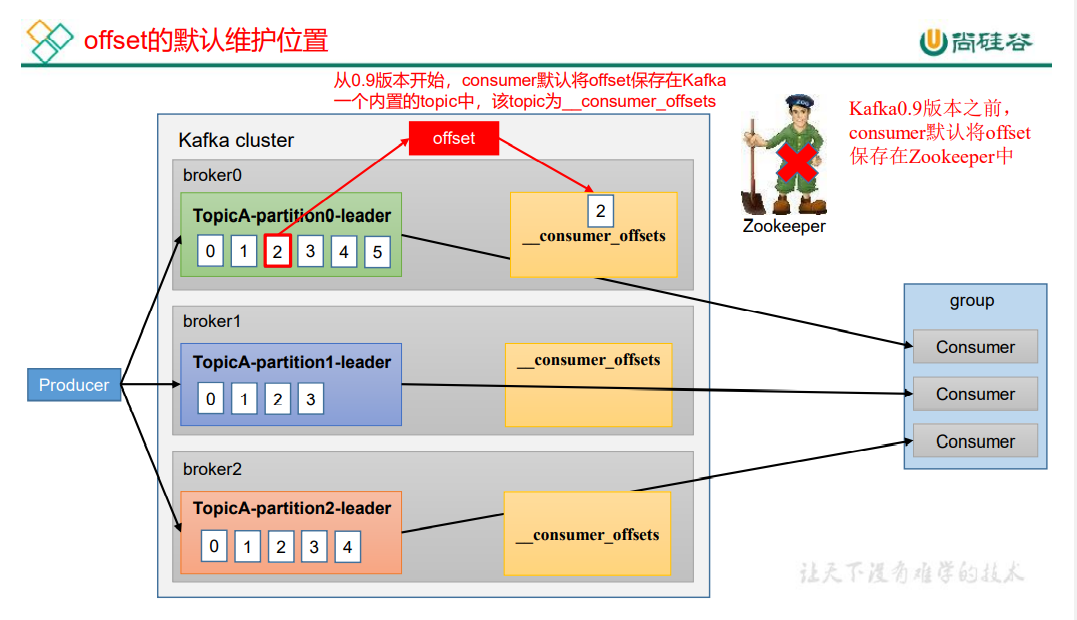
5.5 offset 位移 5.5.1 offset 的默认维护位置
__consumer_offsets 主题里面采用 key 和 value 的方式存储数据。key 是 group.id+topic+ 分区号,value 就是当前 offset 的值。每隔一段时间,kafka 内部会对这个 topic 进行 compact,也就是每个 group.id+topic+分区号就保留最新数据。
1)消费 offset 案例
(0)思想:__consumer_offsets 为 Kafka 中的 topic,那就可以通过消费者进行消费。
(1)在配置文件 config/consumer.properties 中添加配置 exclude.internal.topics=false, 默认是 true,表示不能消费系统主题。为了查看该系统主题数据,所以该参数修改为 false。
(2)采用命令行方式,创建一个新的 topic。
1
2
[atguigu@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server
(3)启动生产者往 atguigu 生产数据。
1
2
[atguigu@hadoop102 kafka]$ bin/kafka-console-producer.sh --topic
(4)启动消费者消费 atguigu 数据。
1 [atguigu@hadoop104 kafka]$ bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic atguigu --group test
注意:指定消费者组名称,更好观察数据存储位置(key 是 group.id+topic+分区号)。
(5)查看消费者消费主题__consumer_offsets。
1
2
3
4
5
6
7
8
9
10
11
12
[atguigu@hadoop102 kafka]$ bin/kafka-console-consumer.sh --topic
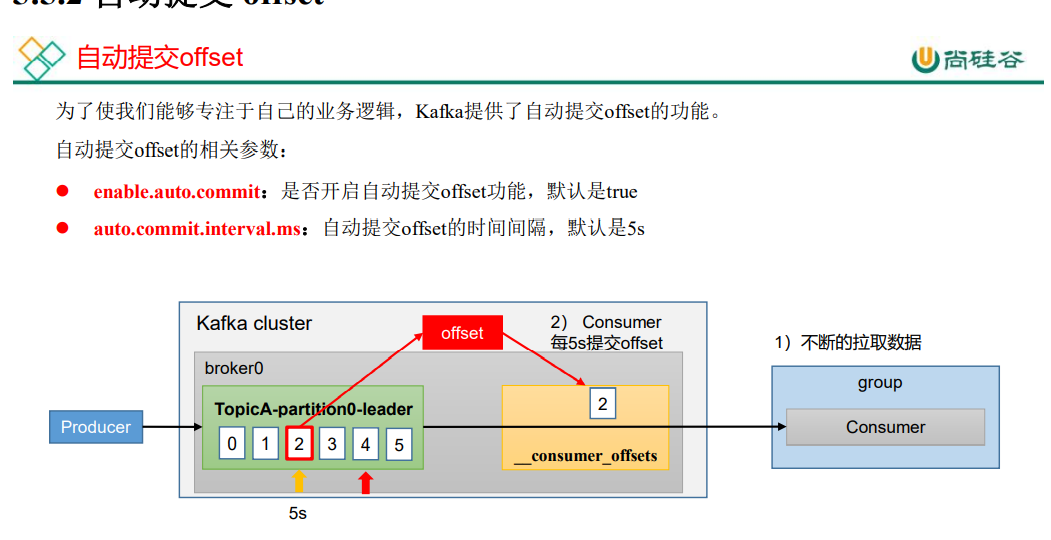
5.5.2 自动提交 offset
参数名称
描述
enable.auto.commit
默认值为 true ,消费者会自动周期性地向服务器提交偏移量。
auto.commit.interval.ms
如果设置了 enable.auto.commit 的值为 true, 则该值定义了消 费者偏移量向 Kafka 提交的频率,默认 5s。
1)消费者自动提交 offset
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import java.util.Arrays;import java.util.Properties;public class CustomConsumerAutoOffset public static void main (String[] args) new Properties();"hadoop102:9092" );"org.apache.kafka.common.serialization.StringDeserializer" );"org.apache.kafka.common.serialization.StringDeserializer" );"test" );true );1000 );new "first" ));while (true ){1 ));for (ConsumerRecord<String, String> consumerRecord :
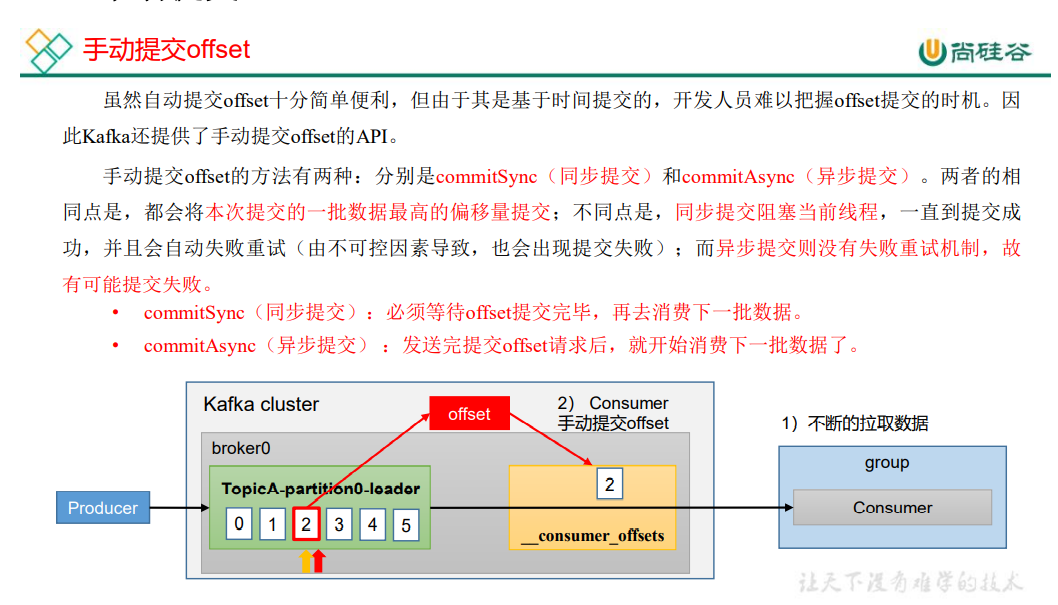
5.5.3 手动提交 offset
1)同步提交 offset
由于同步提交 offset 有失败重试机制,故更加可靠,但是由于一直等待提交结果,提 交的效率比较低。以下为同步提交 offset 的示例。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import java.util.Arrays;import java.util.Properties;public class CustomConsumerByHandSync public static void main (String[] args) new Properties();"hadoop102:9092" );"org.apache.kafka.common.serialization.StringDeserializer" );"org.apache.kafka.common.serialization.StringDeserializer" );"test" );false );new "first" ));while (true ){1 ));for (ConsumerRecord<String, String> consumerRecord :
2)异步提交 offset
虽然同步提交 offset 更可靠一些,但是由于其会阻塞当前线程,直到提交成功。因此 吞吐量会受到很大的影响。因此更多的情况下,会选用异步提交 offset 的方式。
以下为异步提交 offset 的示例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.*;import org.apache.kafka.common.TopicPartition;import java.util.Arrays;import java.util.Map;import java.util.Properties;public class CustomConsumerByHandAsync public static void main (String[] args) new Properties();"hadoop102:9092" );"org.apache.kafka.common.serialization.StringDeserializer" );"org.apache.kafka.common.serialization.StringDeserializer" );"test" );"false" );new "first" ));while (true ){1 ));for (ConsumerRecord<String, String> consumerRecord :
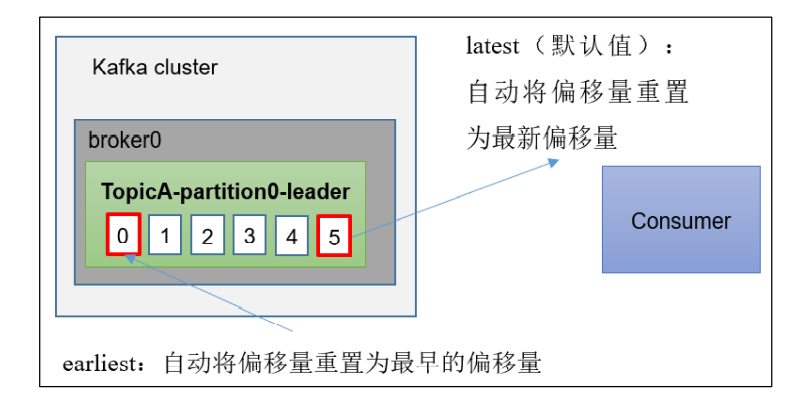
5.5.4 指定 Offset 消费 auto.offset.reset = earliest | latest | none > 默认是 latest。
当 Kafka 中没有初始偏移量(消费者组第一次消费)或服务器上不再存在当前偏移量 时(例如该数据已被删除),该怎么办?earliest >:自动将偏移量重置为最早的偏移量,–from-beginning。
(2)latest(默认值) :自动将偏移量重置为最新偏移量。
(3)none:如果未找到消费者组的先前偏移量,则向消费者抛出异常。
(4)任意指定 offset 位移开始消费
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import org.apache.kafka.common.TopicPartition;import org.apache.kafka.common.serialization.StringDeserializer;import java.time.Duration;import java.util.ArrayList;import java.util.HashSet;import java.util.Properties;import java.util.Set;public class CustomConsumerSeek public static void main (String[] args) new Properties();"hadoop102:9092" );"test2" );new new ArrayList<>();"first" );new HashSet<>();while (assignment.size() == 0 ) {1 ));for (TopicPartition tp: assignment) {1700 );while (true ) {1 ));for (ConsumerRecord<String, String> consumerRecord :
注意:每次执行完,需要修改消费者组名;
5.5.5 指定时间消费 需求:在生产环境中,会遇到最近消费的几个小时数据异常,想重新按照时间消费。 例如要求按照时间消费前一天的数据,怎么处理?
操作步骤:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
package com.atguigu.kafka.consumer;import org.apache.kafka.clients.consumer.*;import org.apache.kafka.common.TopicPartition;import org.apache.kafka.common.serialization.StringDeserializer;import java.time.Duration;import java.util.*;public class CustomConsumerForTime public static void main (String[] args) new Properties();"hadoop102:9092" );"test2" );new new ArrayList<>();"first" );new HashSet<>();while (assignment.size() == 0 ) {1 ));new for (TopicPartition topicPartition : assignment) {1 * 24 * 3600 * 1000 );for (TopicPartition topicPartition : assignment) {if (offsetAndTimestamp != null ){while (true ) {1 ));for (ConsumerRecord<String, String> consumerRecord :
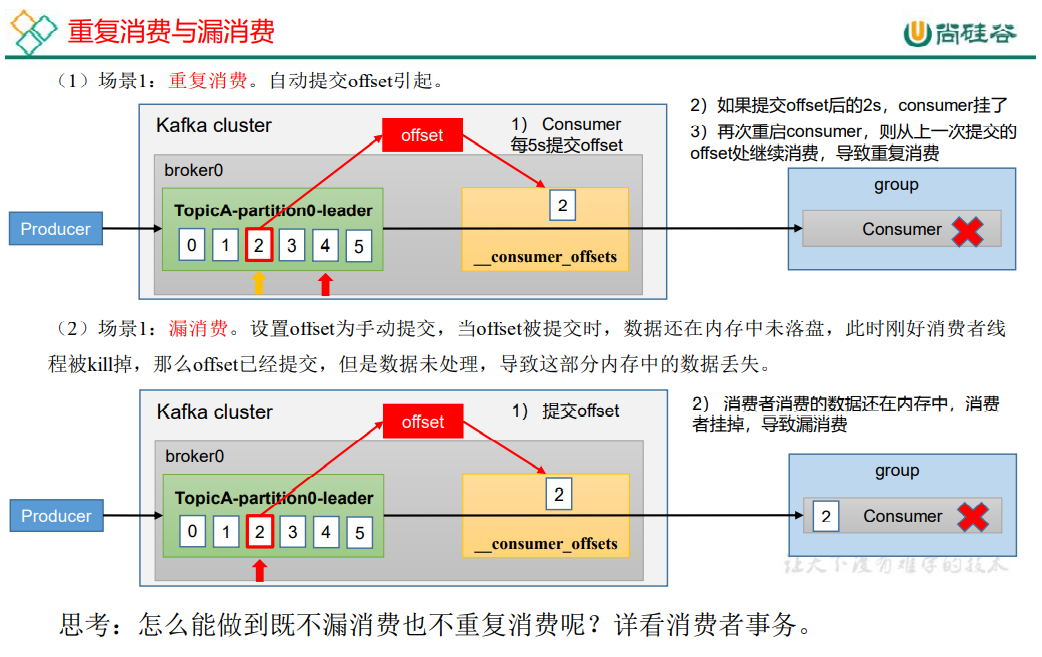
5.5.6 漏消费和重复消费 重复消费 :已经消费了数据,但是 offset 没提交。
漏消费 :先提交 offset 后消费,有可能会造成数据的漏消费。
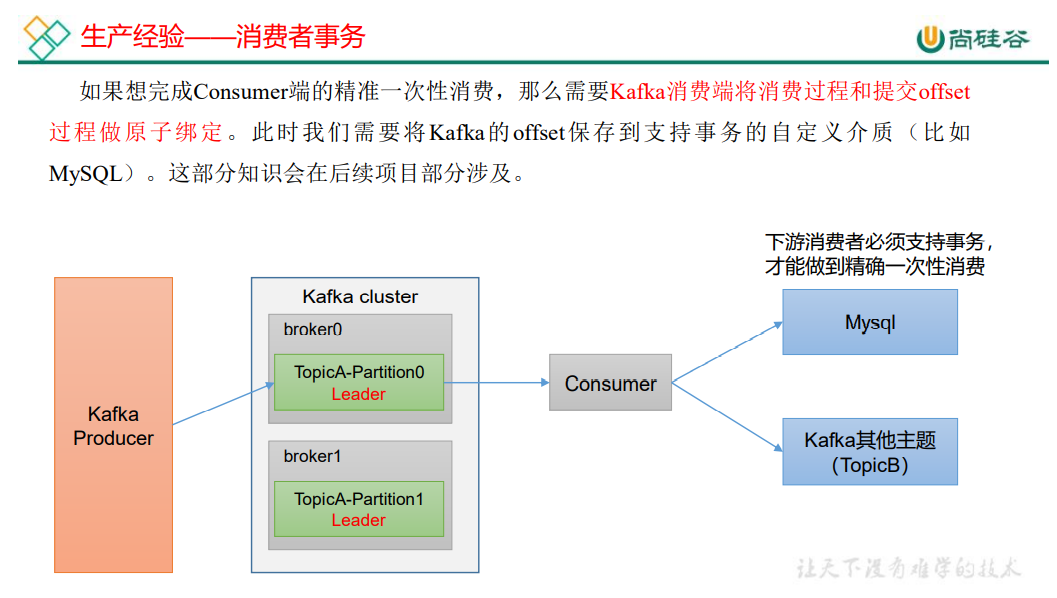
5.6 生产经验——消费者事务
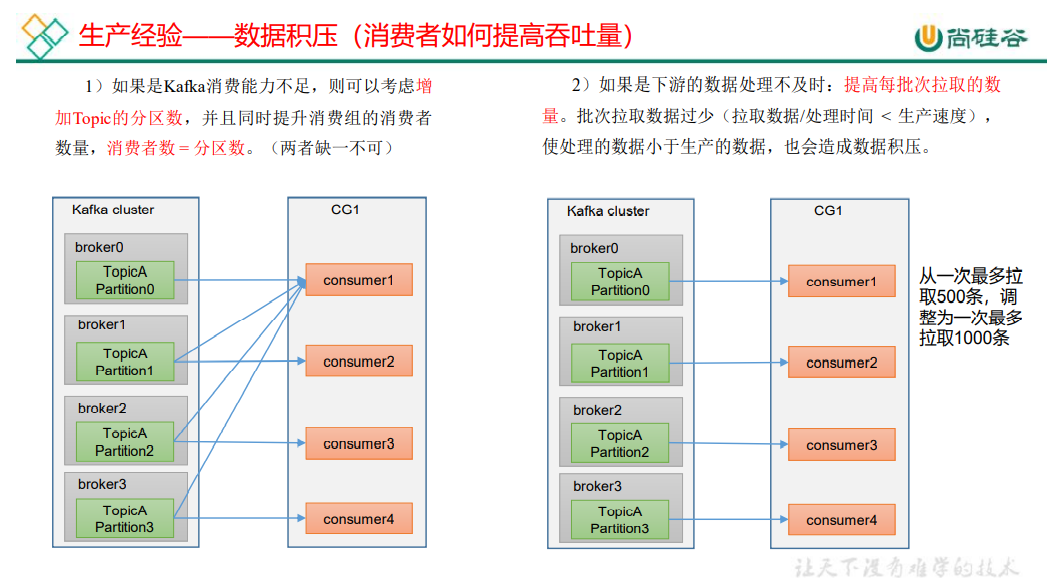
5.7 生产经验——数据积压(消费者如何提高吞吐量)
参数名称
描述
fetch.max.bytes
默认 Default: 52428800(50 m) 。消费者获取服务器端一批 消息最大的字节数。如果服务器端一批次的数据大于该值 (50m)仍然可以拉取回来这批数据,因此,这不是一个绝 对最大值。一批次的大小受 message.max.bytes (broker config)or max.message.bytes (topic config)影响。
max.poll.records
一次 poll 拉取数据返回消息的最大条数,默认是 500 条
第 6 章 Kafka-Eagle 监控 Kafka-Eagle 框架可以监控 Kafka 集群的整体运行情况,在生产环境中经常使用。
6.1 MySQL 环境准备 Kafka-Eagle 的安装依赖于 MySQL,MySQL 主要用来存储可视化展示的数据。如果集 群中之前安装过 MySQL 可以跨过该步。
6.2 Kafka 环境准备 1)关闭 Kafka 集群
1 [atguigu@hadoop102 kafka]$ kf.sh stop
2)修改/opt/module/kafka/bin/kafka-server-start.sh 命令中
1 [atguigu@hadoop102 kafka]$ vim bin/kafka-server-start.sh
修改如下参数值:
1
2
3
if [ "x$KAFKA_HEAP_OPTS" = "x" ]; then
为
1
2
3
4
5
6
7
8
9
if [ "x$KAFKA_HEAP_OPTS" = "x" ]; then # export KAFKA_HEAP_OPTS="-Xmx1G -Xms1G"
注意:修改之后在启动 Kafka 之前要分发之其他节点
1 [atguigu@hadoop102 bin]$ xsync kafka-server-start.sh
6.3 Kafka-Eagle 安装 0)官网:https://www.kafka-eagle.org/
1)上传压缩包 kafka-eagle-bin-2.0.8.tar.gz 到集群/opt/software 目录
2)解压到本地
1 [atguigu@hadoop102 software]$ tar -zxvf kafka-eagle-bin2.0.8.tar.gz
3)进入刚才解压的目录
1
2
3
[atguigu@hadoop102 kafka-eagle-bin-2.0.8]$ ll
4)将 efak-web-2.0.8-bin.tar.gz 解压至/opt/module
1 [atguigu@hadoop102 kafka-eagle-bin-2.0.8]$ tar -zxvf efak-web2.0.8-bin.tar.gz -C /opt/module/
5)修改名称
1 [atguigu@hadoop102 module]$ mv efak-web-2.0.8/ efak
6)修改配置文件 /opt/module/efak/conf/system-config.properties
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
[atguigu@hadoop102 conf]$ vim system-config.properties instead efak.zk.cluster.alias =cluster1 cluster1.zk.list =hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka cluster1.zk.acl.enable =false cluster1.zk.acl.schema =digest cluster1.zk.acl.username =test cluster1.zk.acl.password =test123 cluster1.efak.broker.size =20 kafka.zk.limit.size =32 efak.webui.port =8048 cluster1.efak.jmx.acl =false cluster1.efak.jmx.user =keadmin cluster1.efak.jmx.password =keadmin123 cluster1.efak.jmx.ssl =false cluster1.efak.jmx.truststore.location =/data/ssl/certificates/kafka.truststor e cluster1.efak.jmx.truststore.password =ke123456 cluster1.efak.offset.storage =kafka cluster1.efak.jmx.uri =service:jmx:rmi:///jndi/rmi://%s/jmxrmi efak.metrics.charts =true efak.metrics.retain =15 efak.sql.topic.records.max =5000 efak.sql.topic.preview.records.max =10 efak.topic.token =keadmin cluster1.efak.sasl.enable =false cluster1.efak.sasl.protocol =SASL_PLAINTEXT cluster1.efak.sasl.mechanism =SCRAM-SHA-256 cluster1.efak.sasl.jaas.config =org.apache.kafka.common.security.scram.ScramL oginModule required username="kafka" password="kafka-eagle"; cluster1.efak.sasl.client.id =cluster1.efak.blacklist.topics =cluster1.efak.sasl.cgroup.enable =false cluster1.efak.sasl.cgroup.topics =cluster2.efak.sasl.enable =false cluster2.efak.sasl.protocol =SASL_PLAINTEXT cluster2.efak.sasl.mechanism =PLAIN cluster2.efak.sasl.jaas.config =org.apache.kafka.common.security.plain.PlainL oginModule required username="kafka" password="kafka-eagle"; cluster2.efak.sasl.client.id =cluster2.efak.blacklist.topics =cluster2.efak.sasl.cgroup.enable =false cluster2.efak.sasl.cgroup.topics =cluster3.efak.ssl.enable =false cluster3.efak.ssl.protocol =SSL cluster3.efak.ssl.truststore.location =cluster3.efak.ssl.truststore.password =cluster3.efak.ssl.keystore.location =cluster3.efak.ssl.keystore.password =cluster3.efak.ssl.key.password =cluster3.efak.ssl.endpoint.identification.algorithm =https cluster3.efak.blacklist.topics =cluster3.efak.ssl.cgroup.enable =false cluster3.efak.ssl.cgroup.topics =efak.driver =com.mysql.jdbc.Driver efak.url =jdbc:mysql://hadoop102:3306/ke?useUnicode=true&characterEncoding=UT F-8&zeroDateTimeBehavior =convertToNull efak.username =root efak.password =000000 TF-8&zeroDateTimeBehavior =convertToNull
7)添加环境变量
1
2
3
4
5
6
[atguigu@hadoop102 conf]$ sudo vim /etc/profile.d/my_env.sh# kafkaEFAK
注意:source /etc/profile
1 [atguigu@hadoop102 conf]$ source /etc/profile
8)启动
(1)注意:启动之前需要先启动 ZK 以及 KAFKA。
1 [atguigu@hadoop102 kafka]$ kf.sh start
(2)启动 efak
1
2
3
4
5
6
7
8
9
10
[atguigu@hadoop102 efak]$ bin/ke.sh start
说明:如果停止 efak,执行命令。
1 [atguigu@hadoop102 efak]$ bin/ke.sh stop
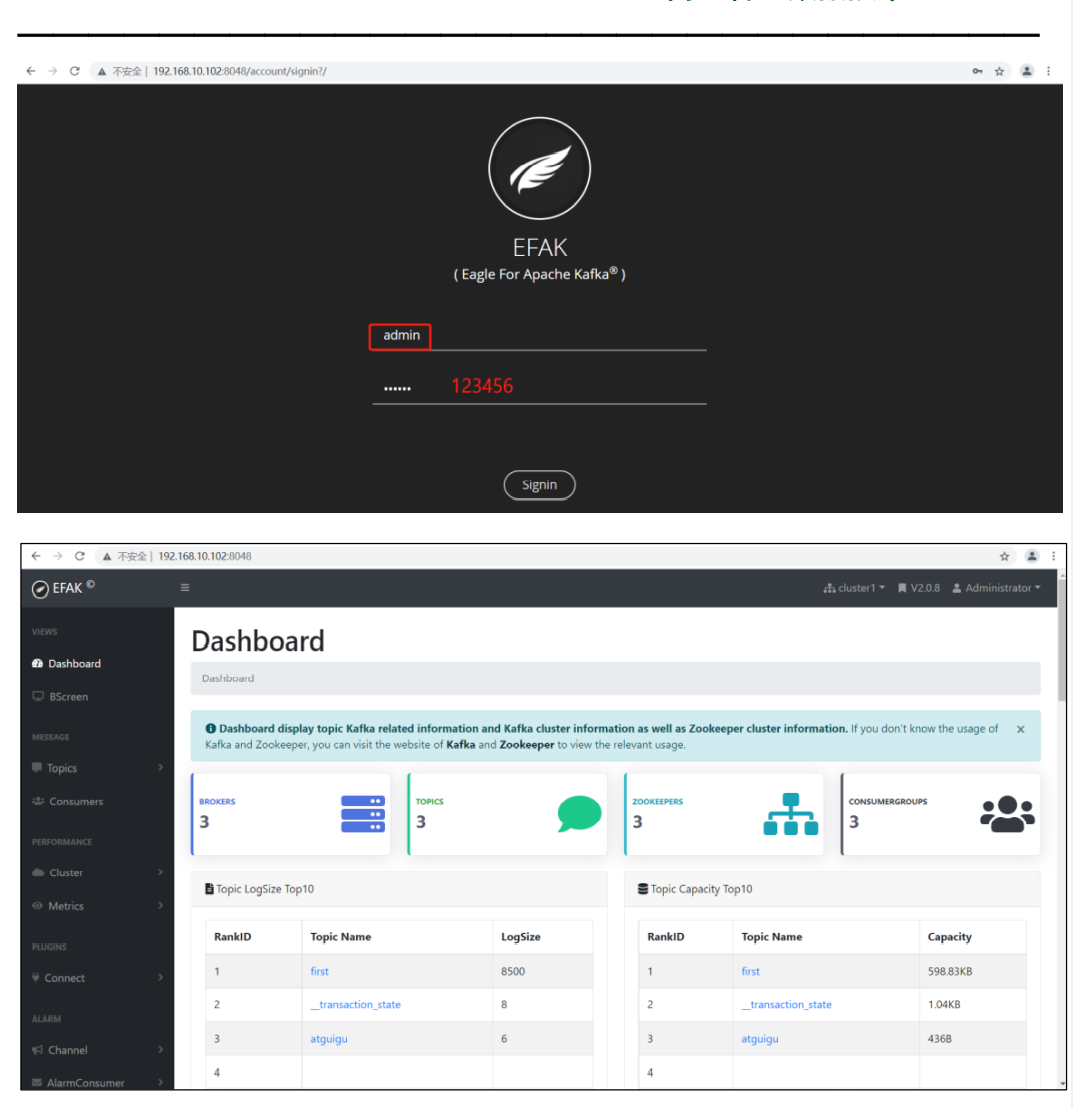
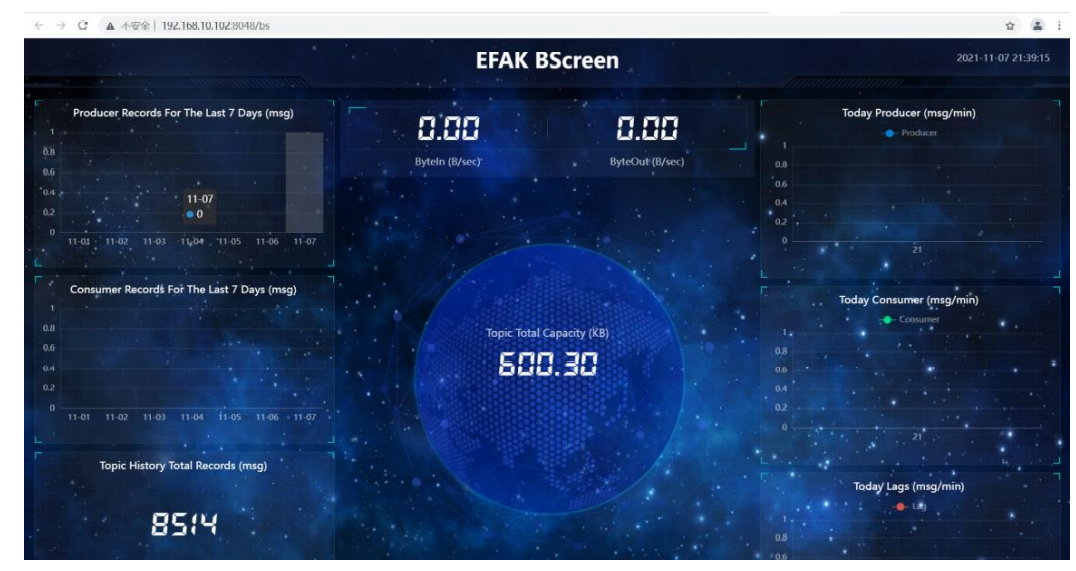
6.4 Kafka-Eagle 页面操作 1)登录页面查看监控数据
http://192.168.10.102:8048/
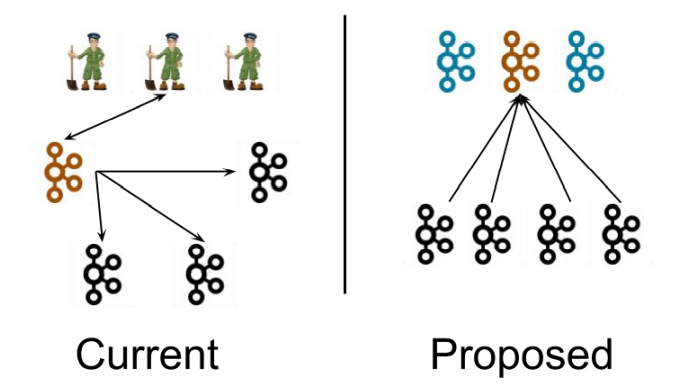
第 7 章 Kafka-Kraft 模式 7.1 Kafka-Kraft 架构
左图为 Kafka 现有架构,元数据在 zookeeper 中,运行时动态选举 controller,由 controller 进行 Kafka 集群管理。右图为 kraft 模式架构(实验性),不再依赖 zookeeper 集群, 而是用三台 controller 节点代替 zookeeper,元数据保存在 controller 中,由 controller 直接进 行 Kafka 集群管理。
这样做的好处有以下几个:
Kafka 不再依赖外部框架,而是能够独立运行;
controller 管理集群时,不再需要从 zookeeper 中先读取数据,集群性能上升;
由于不依赖 zookeeper,集群扩展时不再受到 zookeeper 读写能力限制;
controller 不再动态选举,而是由配置文件规定。这样我们可以有针对性的加强 controller 节点的配置,而不是像以前一样对随机 controller 节点的高负载束手无策。
7.2 Kafka-Kraft 集群部署 1)再次解压一份 kafka 安装包
1
2
[atguigu@hadoop102 software]$ tar -zxvf kafka_2.12-3.0.0.tgz -C
2)重命名为 kafka2
1 [atguigu@hadoop102 module]$ mv kafka_2.12-3.0.0/ kafka2
3)在 hadoop102 上修改/opt/module/kafka2/config/kraft/server.properties 配置文件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
[atguigu@hadoop102 kraft]$ vim server.properties 能) process.roles =broker, controller node.id =2 controller.listener.names =CONTROLLER controller.quorum.voters =2@hadoop102:9093,3@hadoop103:9093,4@hado op104 :9093 listeners =PLAINTEXT://:9092,CONTROLLER://:9093 inter.broker.listener.name =PLAINTEXT advertised.Listeners =PLAINTEXT://hadoop102:9092 listener.security.protocol.map =CONTROLLER:PLAINTEXT,PLAINTEXT:PLA INTEXT,SSL :SSL,SASL_PLAINTEXT:SASL_PLAINTEXT,SASL_SSL:SASL_SSL log.dirs =/opt/module/kafka2/data
4)分发 kafka2
1 [atguigu@hadoop102 module]$ xsync kafka2/
在 hadoop103 和 hadoop104 上 需 要 对 node.id 相应改变 , 值 需 要 和 controller.quorum.voters 对应。
在 hadoop103 和 hadoop104 上需要 根据各自的主机名称,修改相应的 advertised.Listeners 地址。
5)初始化集群数据目录
(1)首先生成存储目录唯一 ID。
1 2 [atguigu@hadoop102 kafka2]$ bin/kafka-storage.sh random-uuid
(2)用该 ID 格式化 kafka 存储目录(三台节点)。
1 2 3 4 5 6 7 8 9 10 11 [atguigu@hadoop102 kafka2]$ bin/kafka-storage.sh format -t
6)启动 kafka 集群
1 2 3 4 5 6 7 8 9 [atguigu@hadoop102 kafka2]$ bin/kafka-server-start.sh -daemon
7)停止 kafka 集群
1 2 3 [atguigu@hadoop102 kafka2]$ bin/kafka-server-stop.sh
7.3 Kafka-Kraft 集群启动停止脚本 1)在/home/atguigu/bin 目录下创建文件 kf2.sh 脚本文件
1 [atguigu@hadoop102 bin]$ vim kf2.sh
脚本如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 # ! /bin/bash
2)添加执行权限
1 [atguigu@hadoop102 bin]$ chmod +x kf2.sh
3)启动集群命令
1 [atguigu@hadoop102 ~]$ kf2.sh start
4)停止集群命令
1 [atguigu@hadoop102 ~]$ kf2.sh stop