day12-IO流
day12【IO流】
今日内容
- 字符集
- 字符流
- 转换流
- 字符缓冲流
- 打印流
- 对象序列化
- commons-io
教学目标
- 能够说出常用的编码表
- 能够使用OutputStreamWriter写数据到文件
- 能够使用InputStreamReader读取数据
- 能够使用FileWirter写数据到文件
- 能够说出FileWriter中关闭和刷新方法的区别
- 能够使用FileWriter写数据实现换行和追加写
- 能够使用FileReader读数据
- 能够使用BufferedWriter写换行
- 能够使用BufferedReader读取文本行
- 能够说出打印流的特点
第一章 字符编码和字符集
1.1 字符编码
计算机中储存的信息都是用二进制数表示的,而我们在屏幕上看到的数字、英文、标点符号、汉字等字符是二进制数转换之后的结果。按照某种规则,将字符存储到计算机中,称为编码 。反之,将存储在计算机中的二进制数按照某种规则解析显示出来,称为解码 。比如说,按照A规则存储,同样按照A规则解析,那么就能显示正确的文本f符号。反之,按照A规则存储,再按照B规则解析,就会导致乱码现象。
编码: 字符转换为字节。
解码:字节转换为字符。
字符编码
Character Encoding: 就是一套自然语言的字符与二进制数之间的对应规则。生活中的文字和计算机文字的对应关系 a–>97–>0110 0001
1.2 字符集
- **字符集
Charset**:也叫编码表。是一个系统支持的所有字符的集合,包括各国家文字、标点符号、图形符号、数字等。
计算机要准确的存储和识别各种字符集符号,需要进行字符编码,一套字符集必然至少有一套字符编码。常见字符集有ASCII字符集、GBK字符集、Unicode字符集等。
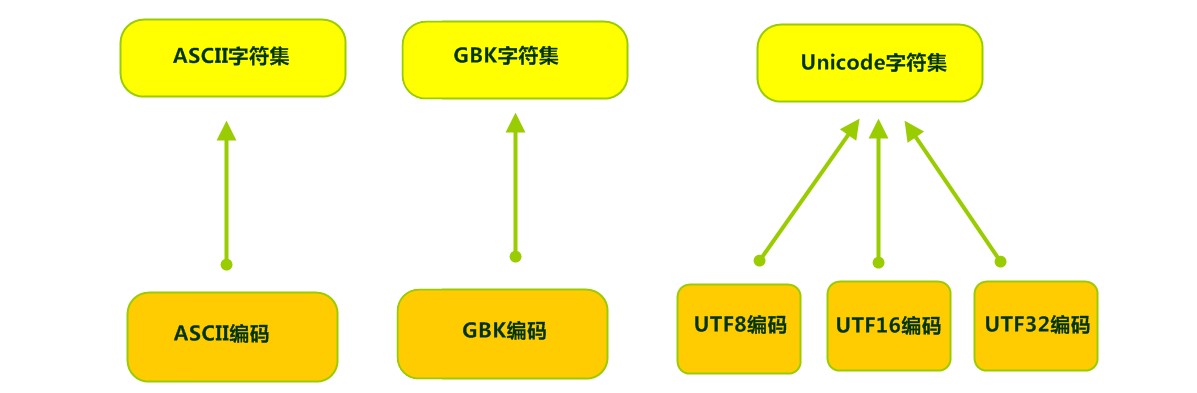
可见,当指定了编码,它所对应的字符集自然就指定了,所以编码才是我们最终要关心的。
- ASCII字符集 :
- ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)是基于拉丁字母的一套电脑编码系统,用于显示现代英语,主要包括控制字符(回车键、退格、换行键等)和可显示字符(英文大小写字符、阿拉伯数字和西文符号)。
- 基本的ASCII字符集,使用7位(bits)表示一个字符,共128字符。ASCII的扩展字符集使用8位(bits)表示一个字符,共256字符,方便支持欧洲常用字符。
- ISO-8859-1字符集:
- 拉丁码表,别名Latin-1,用于显示欧洲使用的语言,包括荷兰、丹麦、德语、意大利语、西班牙语等。
- ISO-8859-1使用单字节编码,兼容ASCII编码。
- GBxxx字符集:
- GB就是国标的意思,是为了显示中文而设计的一套字符集。
- GB2312:简体中文码表。一个小于127的字符的意义与原来相同。但两个大于127的字符连在一起时,就表示一个汉字,这样大约可以组合了包含7000多个简体汉字,此外数学符号、罗马希腊的字母、日文的假名们都编进去了,连在ASCII里本来就有的数字、标点、字母都统统重新编了两个字节长的编码,这就是常说的”全角”字符,而原来在127号以下的那些就叫”半角”字符了。
- GBK:最常用的中文码表。是在GB2312标准基础上的扩展规范,使用了双字节编码方案,共收录了21003个汉字,完全兼容GB2312标准,同时支持繁体汉字以及日韩汉字等。
- 中文版操作系统使用的编码表就是GBK。
- 中文汉字在2312和GBK编码表中均为两个字节表示,第一个字节为负数,第二个字节可能是负数也可能是正数。
- GB18030:最新的中文码表。收录汉字70244个,采用多字节编码,每个字可以由1个、2个或4个字节组成。支持中国国内少数民族的文字,同时支持繁体汉字以及日韩汉字等。尚未正式启用。
- Unicode字符集 :
- Unicode编码系统为表达任意语言的任意字符而设计,是业界的一种标准,也称为统一码、标准万国码。
- 它最多使用4个字节的数字来表达每个字母、符号,或者文字。有三种编码实现方案,UTF-8、UTF-16和UTF-32。最为常用的UTF-8编码。
- UTF-8编码,可以用来表示Unicode标准中任何字符,它是电子邮件、网页及其他存储或传送文字的应用中,优先采用的编码。互联网工程工作小组(IETF)要求所有互联网协议都必须支持UTF-8编码。所以,我们开发Web应用,也要使用UTF-8编码。它使用一至四个字节为每个字符编码,编码规则:
- 128个US-ASCII字符,只需一个字节编码。
- 拉丁文等字符,需要二个字节编码。
- 大部分常用字(含中文),使用三个字节编码。
- 其他极少使用的Unicode辅助字符,使用四字节编码。
- UTF-8是变长编码表,汉字在UTF-8中均为负数。
1.3 String类getBytes()方法介绍
- byte[] getBytes() 使用平台的默认字符集将此 String编码为字节序列,将结果存储到新的字节数组中。
- 使用平台默认字符集,将字符串编码为字节数组。
- 平台通常指的是操作系统平台,而中文版操作系统平台的默认字符集是GBK。
1 | |
以上程序的执行结果为:[-28, -67, -96],3个字节,而GBK字符集汉字占用2个字节,UTF-8字符集汉字占有3个字节。
原因:IDEA启动JVM的时候,添加了启动参数: java -Dfile.encoding=UTF-8,启动JVM的时候将默认的字符集设置为了UTF-8。
- byte[] getBytes(String charsetName )使用指定的字符集将此 String 编码为 byte 序列,并将结果存储到一个新的 byte 数组中。
1 | |
常用编码表:GBK和UTF-8。
第二章 转换流
2.1 转换流OutputStreamWriter
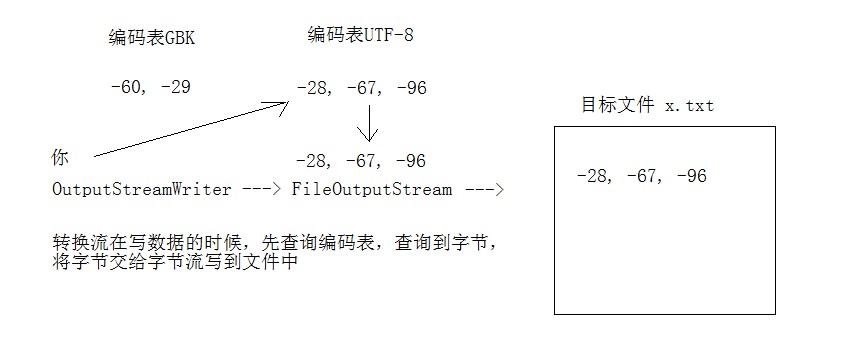
java.io.OutputStreamwriter类,继承Writer类,他是字符输出流,只能操作文本文件,不能操作其他类型文件。OutputStreamwriter是字符流通向字节流的桥梁(字符流转成字节流),使用指定的字符集将字符编码为字节。它的字符集可以由名称指定,也可以接受平台的默认字符集。
2.2 OutputStreamWriter常用方法
构造方法
OutputStreamWriter(OutputStream in): 创建一个使用默认字符集的字符流。OutputStreamWriter(OutputStream in, String charsetName): 创建一个指定字符集的字符流。
1 | |
写出数据方法
void write(int c)写出单个字符。void write(char[] ch)写出字符数组。void write(char[] ch,int off,int len)写出字符数组一部分,开始索引和写出的个数。void write(String s)写入字符串。void flush()刷新该流的缓冲,字符流写数据会先写在内存中,刷新后才会到达目的文件。
1 | |
2.3 转换流InputStreamReader
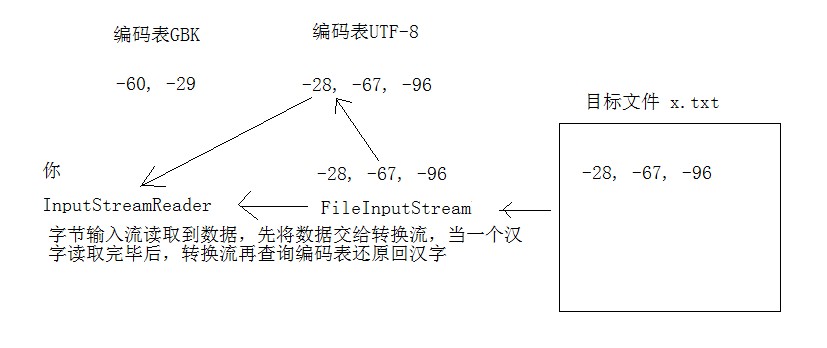
java.io.InputStreamReader类,继承Reader类,他是字符输入流,只能操作文本文件,不能操作其他类型文件。InputStreamReader是字节流通向字符流的桥梁(字节流转成字符流),使用指定的字符集将字符编码为字节。它的字符集可以由名称指定,也可以接受平台的默认字符集。
2.4 InputStreamReader常用方法
构造方法
InputStreamReader(InputStream in): 创建一个使用默认字符集的字符流。InputStreamReader(InputStream in, String charsetName): 创建一个指定字符集的字符流。
1 | |
读取数据方法
int read()读取单个字符,读取到文件末尾时返回-1。int read(char[] ch)读取字符存储到数组中个,返回读取到的字符个数,读取到文件末尾时返回-1。
1 | |
第三章 字符流便捷类
3.1 概述
使用转换流进行文本文件的读写可以进行编码表的设置,但是我们经常使用的是平台默认的编码表进行文本文件操作的,因此可以选择字符流的便捷类来使用。
FileWriter继承OutputStreamWriter,使用平台默认编码表写出数据。
FileReader继承InputStreamReader,使用平台默认编码表读取数据。
3.2 FileWriter类
构造方法
FileWriter(File file): 创建一个新的 FileWriter,给定要读取的File对象。FileWriter(String fileName): 创建一个新的 FileWriter,给定要读取的文件的名称。
写出数据
1 | |
注意:字符串输出数据,必须要使用flush()方法,否则数据在内存中,不会到达指定文件,close()方法在关闭前也会进行刷新,推荐写一次刷新一次,避免内存占用过多。
3.2 FileReader类
构造方法
FileWriter(File file): 创建一个新的 FileWriter,给定要读取的File对象。FileWriter(String fileName): 创建一个新的 FileWriter,给定要读取的文件的名称。
读取数据
1 | |
第四章 字符缓冲流
4.1 构造方法
public BufferedReader(Reader in):创建一个 新的缓冲输入流。public BufferedWriter(Writer out): 创建一个新的缓冲输出流。
1 | |
4.2 特有方法
字符缓冲流的基本方法与普通字符流调用方式一致,不再阐述,我们来看它们具备的特有方法。
- BufferedReader:
public String readLine(): 读一行文字。 - BufferedWriter:
public void newLine(): 写一行行分隔符,由系统属性定义符号。
4.3 newLine()方法写换行符
1 | |
4.4 readLine()读取文本行
1 | |
4.5 文本练习
请将文本信息恢复顺序。
1 | |
案例分析
- 使用流对象逐行读取原文本信息,把读取的信息保存到集合中。
- 使用Collections集合工具类中的方法sort,对集合中的元素按照自定义规则排序。
- 遍历集合,把集合中排序后的文本在写入到新的记事本中。
1 | |
第五章 打印流
5.1 概述
打印流是专门负责数据输出打印的流对象,我们经常使用的控制台输出语句System.out.println(),就是打印流实现的输出。System.out的运行结果就是PrintStream打印流对象。
- PrintStream继承OutputStream,本质上是字节输出流。
- PrintWriter继承Writer,本质上是字符输出流。
打印流的特点:
- 打印流指负责输出数据,不负责数据来源。
- 打印流永远不会抛出IOException。
- 使用PrintWriter打印流,可以开启自动刷新功能。
- 调用println,printf,format三个方法中的一个才能自动刷新。
5.2 PrintWriter类
public PrintWriter(String fileName): 使用指定的文件名创建一个新的打印流。public PrintWriter(OutputStream out):使用指定的字节输出流构造打印流。public PrintWriter(Writer writer):使用指定的字符输出流构造打印流。
1 | |
注意:打印流输出数据是原样输出,打印97,结果看到就是97,而不是a。
第六章 对象序列化
6.1 概述
Java 提供了一种对象序列化的机制。用一个字节序列可以表示一个对象,该字节序列包含该对象的数据、对象的类型和对象中存储的属性等信息。字节序列写出到文件之后,相当于文件中持久保存了一个对象的信息。
反之,该字节序列还可以从文件中读取回来,重构对象,对它进行反序列化。对象的数据、对象的类型和对象中存储的数据信息,都可以用来在内存中创建对象。
6.2 ObjectOutputStream类
java.io.ObjectOutputStream 类,将Java对象的原始数据类型写出到文件,实现对象的持久存储。
构造方法
public ObjectOutputStream(OutputStream out): 创建一个指定OutputStream的ObjectOutputStream。
构造举例,代码如下:
1 | |
序列化操作
一个对象要想序列化,必须满足两个条件:
该类必须实现
java.io.Serializable接口,Serializable是一个标记接口,不实现此接口的类将不会使任何状态序列化或反序列化,会抛出NotSerializableException。该类的所有属性必须是可序列化的。如果有一个属性不需要可序列化的,则该属性必须注明是瞬态(只是使用,不必存储进序列)的,使用
transient关键字修饰。
1 | |
public final void writeObject (Object obj): 将指定的对象写出。
1 | |
6.3 ObjectInputStream类
ObjectInputStream反序列化流,将之前使用ObjectOutputStream序列化的原始数据恢复为对象。
构造方法
public ObjectInputStream(InputStream in): 创建一个指定InputStream的ObjectInputStream。
反序列化操作1
如果能找到一个对象的class文件,我们可以进行反序列化操作,调用ObjectInputStream读取对象的方法:
public final Object readObject (): 读取一个对象。
1 | |
对于JVM可以反序列化对象,它必须是能够找到class文件的类。如果找不到该类的class文件,则抛出一个 ClassNotFoundException 异常。
反序列化操作2
另外,当JVM反序列化对象时,能找到class文件,但是class文件在序列化对象之后发生了修改,那么反序列化操作也会失败,抛出一个InvalidClassException异常。发生这个异常的原因如下:
- 该类的序列版本号与从流中读取的类描述符的版本号不匹配
- 该类包含未知数据类型
- 该类没有可访问的无参数构造方法
Serializable 接口给需要序列化的类,提供了一个序列版本号。serialVersionUID 该版本号的目的在于验证序列化的对象和对应类是否版本匹配。
1 | |
第七章 Commons IO
7.1 Commons IO介绍
IO技术开发中,代码量很大,而且代码的重复率较高。如果我们要遍历目录,拷贝目录就需要使用方法的递归调用,也增大了程序的复杂度。
Apache软件基金会,开发了IO技术的工具类commonsIO,大大简化IO开发。
7.2 添加第三方jar包
Apahce软件基金会属于第三方,(Oracle公司第一方法,我们自己第二方吗,其他都是第三方)我们要使用第三方开发好的工具,需要添加jar包。
jar包:就是Java自己的压缩包,包中是开发好的功能,全部以class文件形态出现,我们添加直接使用即可。
- 在module下创建文件夹lib
- 将jar包文件复制到lib文件夹中
- lib文件夹上按鼠标右键,选择
Add as Library- level选项:选择module
7.3 CommonsIO的使用
- IOUtils类
- 静态方法:IOUtils.copy(InputStream in,OutputStream out)传递字节流,实现文件复制。
- 静态方法:IOUtils.closeQuietly(任意流对象)悄悄的释放资源,自动处理close()方法抛出的异常。
- FileUtils类
- 静态方法:FileUtils.copyDirectoryToDirectory(File src,File dest);传递File类型的目录,进行整个目录的复制,自动进行递归遍历。
- 静态方法:writeStringToFile(File file,String str)写字符串到文本文件中。
- 静态方法:readFileToString(File file)读取文本文件,返回字符串。
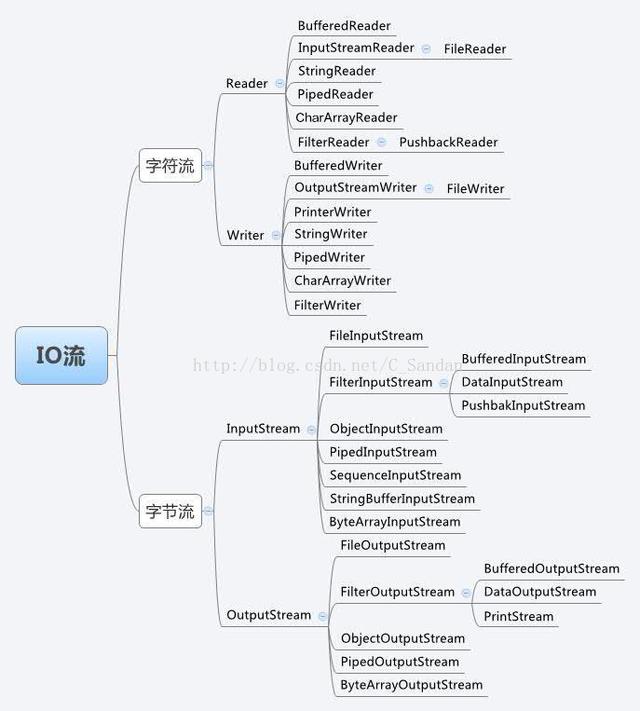
IO流资源图